3 高通量测序原理与生物数据表示
把实验产生的分子信号与文件中的数字、序列和坐标联系起来。
3.1 不同测序实验究竟测到了什么
避免把不同实验的 reads 当作同一种生物学测量。
待完善
3.2 建库、短读长测序与误差来源
理解接头、索引、双端测序和测序错误如何影响数据。
高通量测序技术基础
Illumina 测序技术原理
目前我们接触到的很多生物信息学的技术,都是基于NGS技术的,比如RNA-Seq,ChIP-Seq,FAIRE-Seq,ChIA-PET,Hi-C等等。所谓的NGS就是Next Generation Sequencing,翻译为“下一代测序技术”,或者是“第二代测序技术”。之所以这么叫,是因为相比较于第一代测序技术其测序通量有了很大的提升。
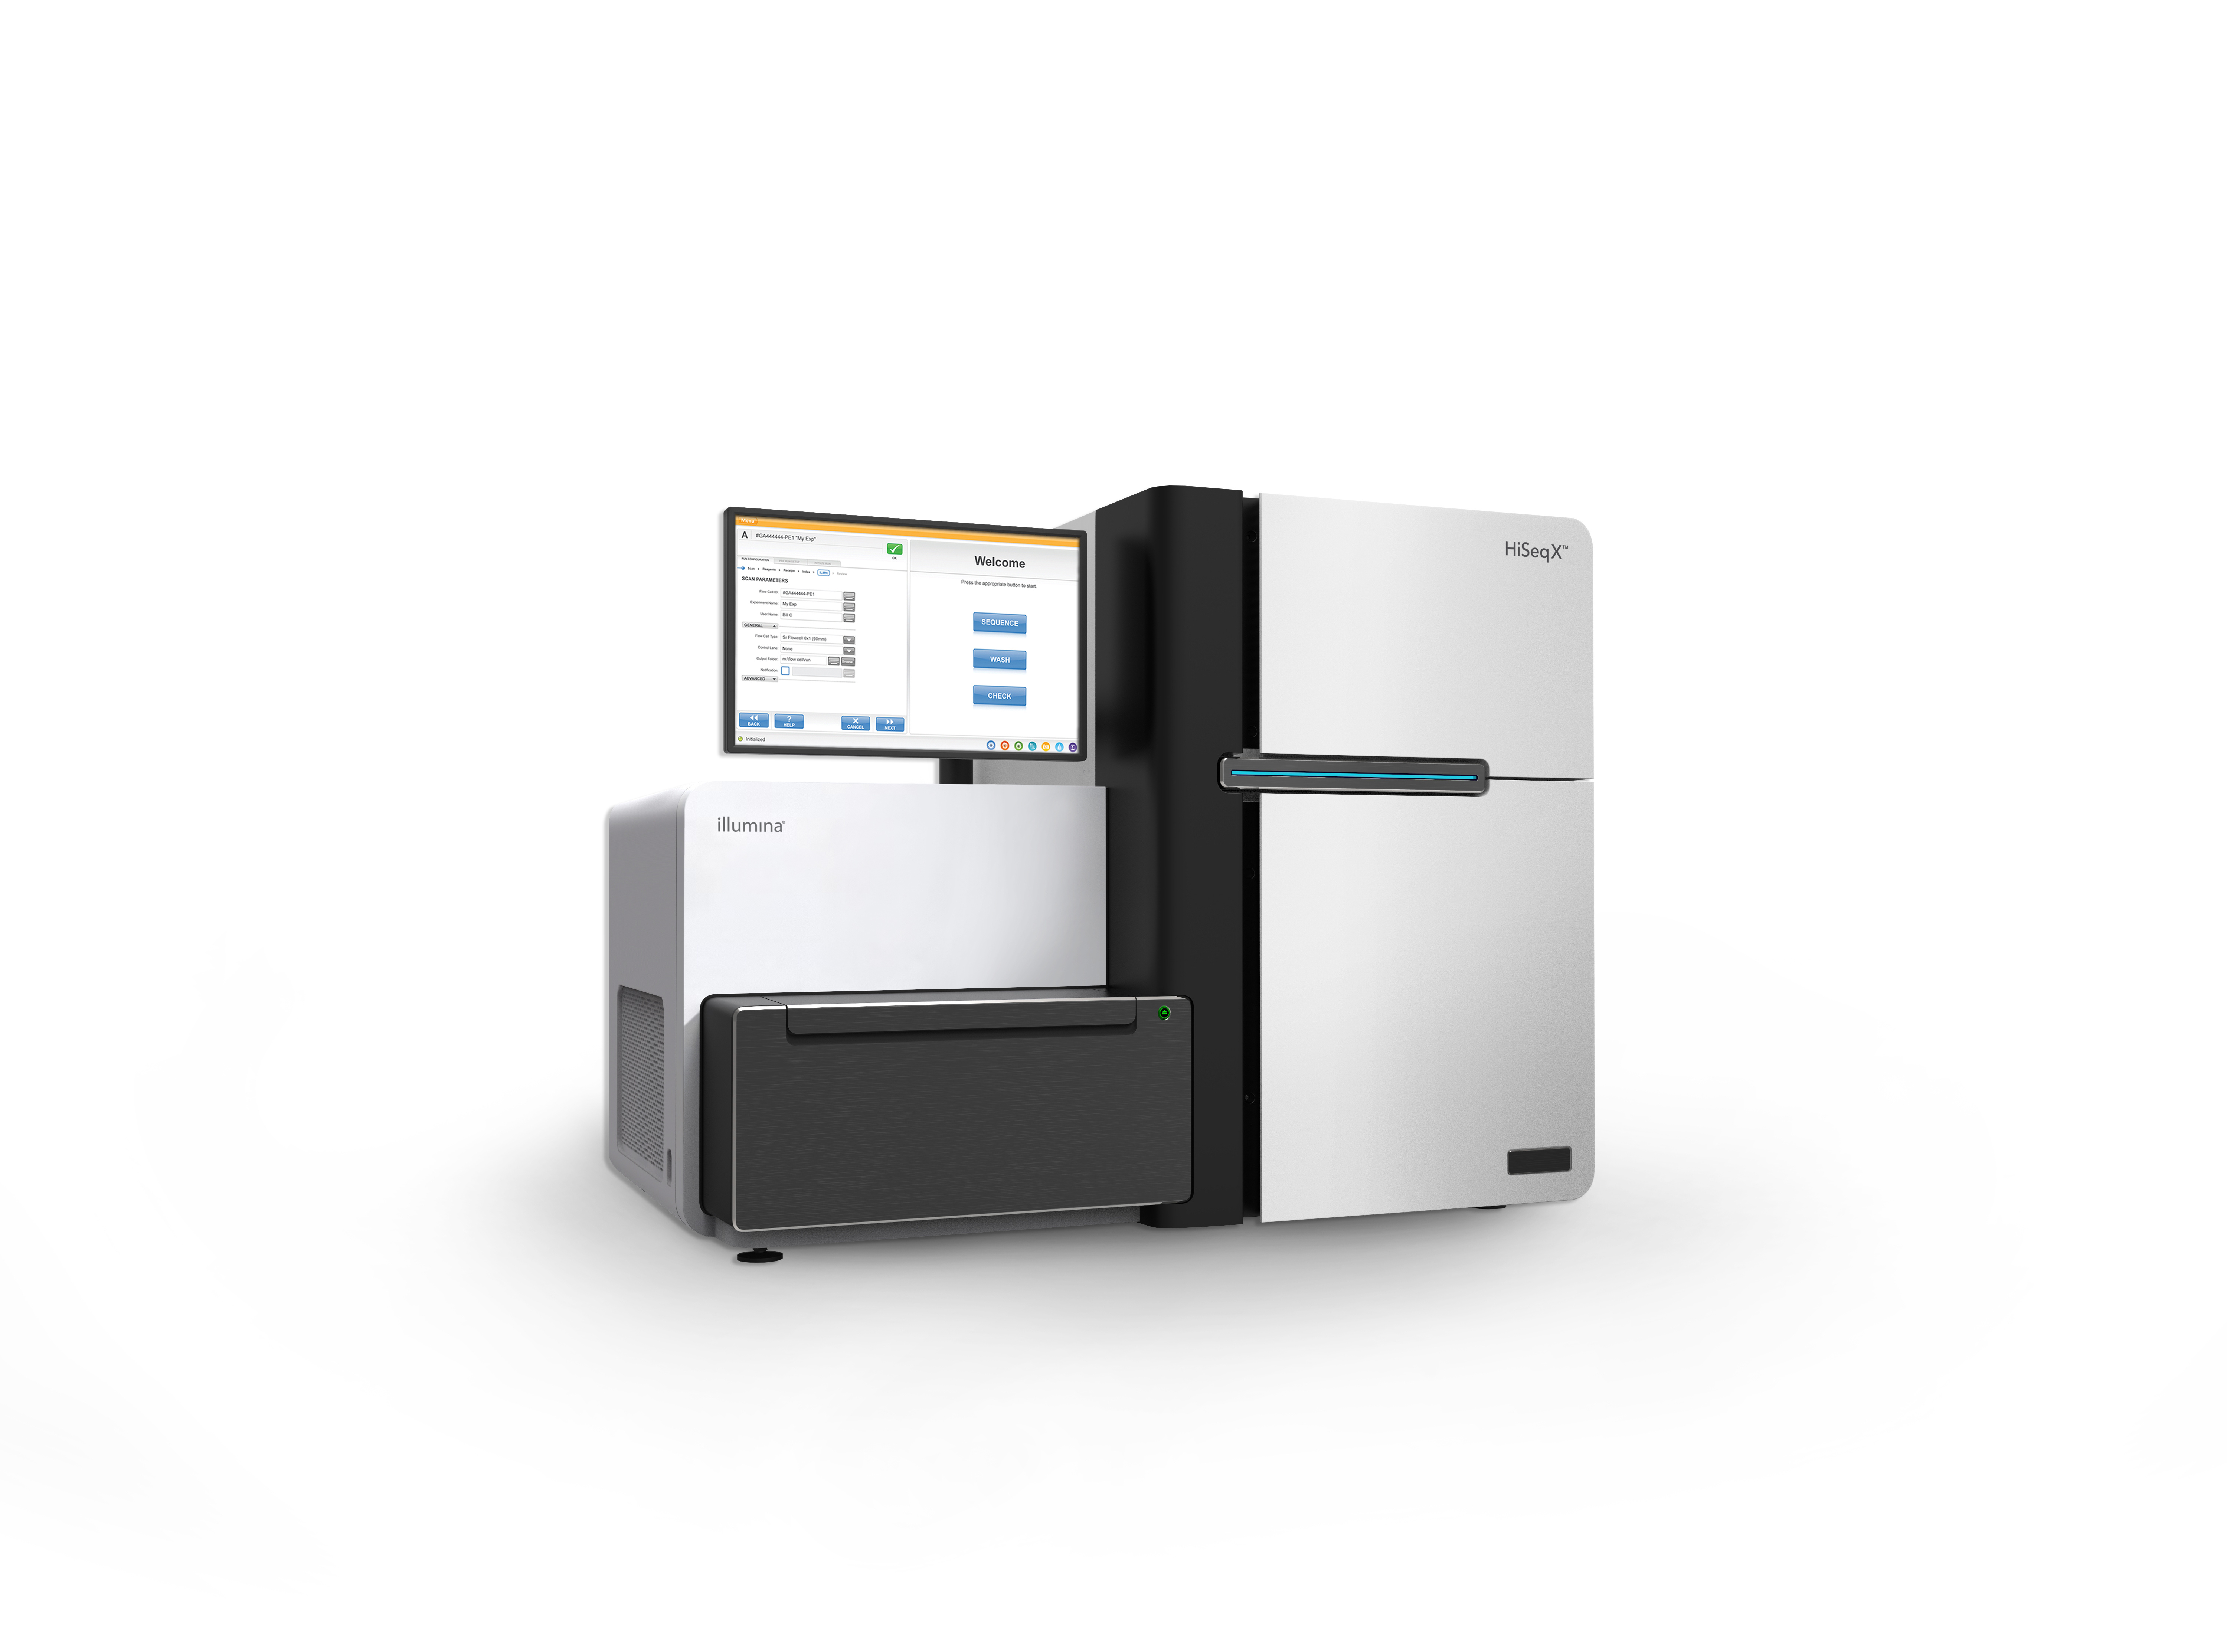
二代测序的发展过程中出现过 Roche 454、Illumina 等不同技术路线。本节以 Illumina 的边合成边测序为例,解释文库、簇和测序循环如何产生 reads。图中的 X Ten 属于原稿写作时期的仪器示例;不同平台的通量、读长和流动槽结构应查对应型号的说明书。
一些常用基本概念的介绍
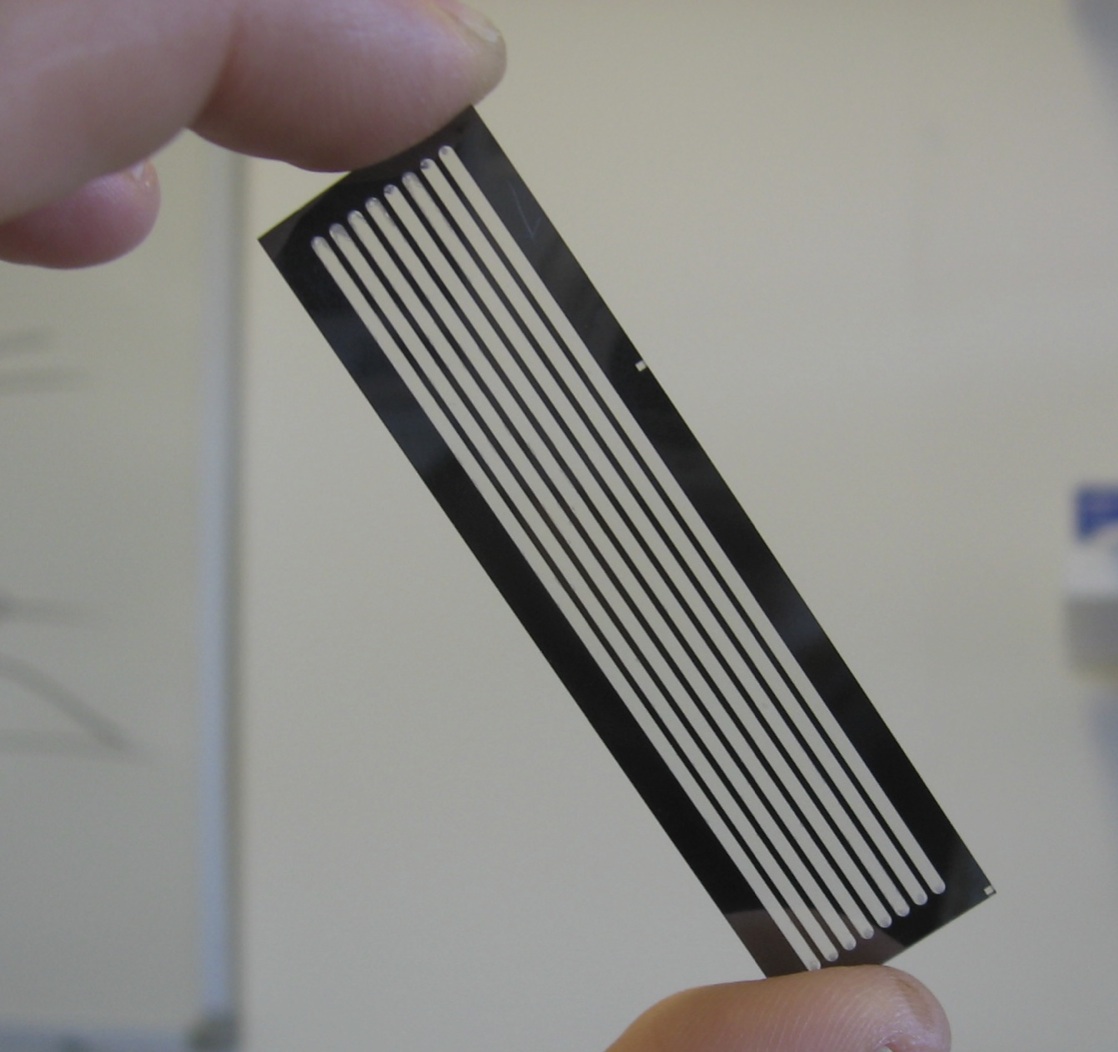
- flowcell(流动槽)是测序反应发生的位置;lane 数目随仪器和流动槽型号变化
- lane(泳道)是流动槽内的反应区域,具体结构取决于平台
- tile 每一次测序荧光扫描的最小单位
- read 指一次读取获得的序列,复数为 reads
- bp base pair 碱基对,用于衡量序列长度
- 双端测序 指从同一插入片段的两端分别读取,例如一个 500 bp 的插入片段两端各读 150 bp
- 未读取区间 在上述例子中,中间还有约 200 bp 未被两端的 reads 覆盖;这段区间不称为 junction。RNA 比对中的 splice junction 通常指剪接连接位点
- adapter 就是测序中需要的一段特定的序列,有类似于引物的功能
- primer PCR中的引物
建库
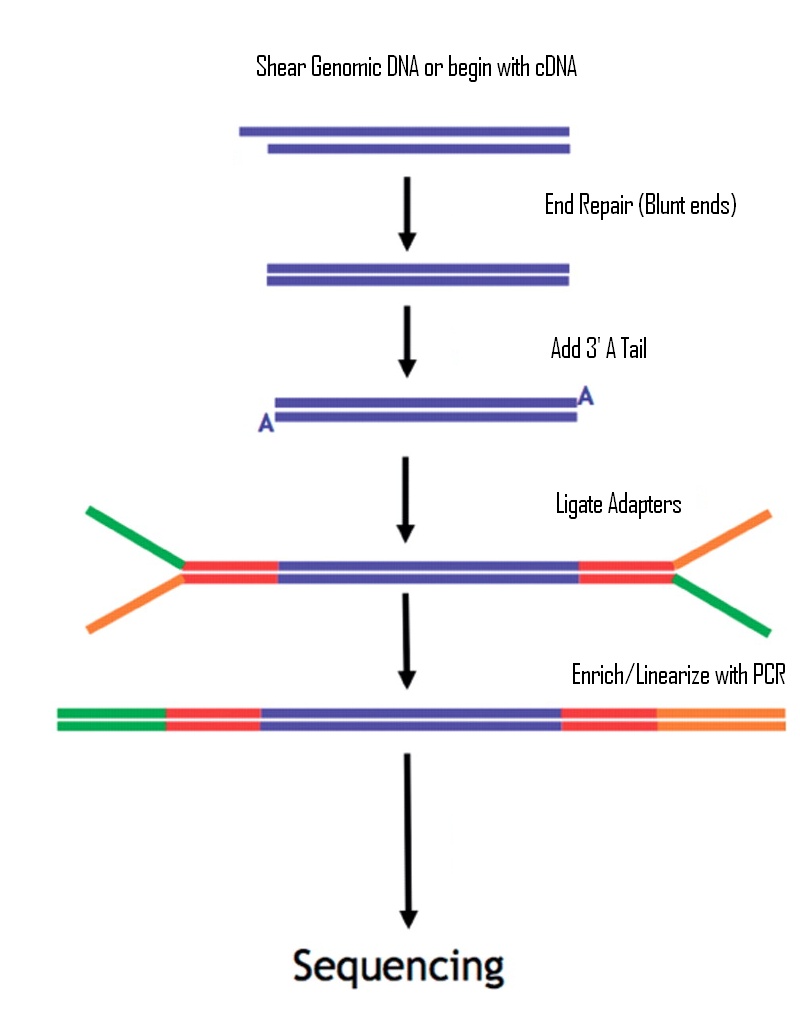
短读长测序每次只能读取有限长度,因此需要先把待测核酸制成适合平台的文库。下面以片段化的 DNA 文库为例:先把较长的 DNA 打断,再通过片段筛选控制长度分布。原稿以 300—500 bp 的插入片段举例;实际范围应按建库方案、读长和研究目的确定。
打断以后会出现末端不平整的情况,用酶补平,所以现在的序列是平末端。
完成补平以后,在3’端使用酶加上一个特异的碱基A
加上A之后就可以利用互补配对的原则,加上adapter,这个adpater可以分成两个部分,一个部分是测序的时候需要用的引物序列,另一部分是建库扩增时候需要用的引物序列
桥式PCR
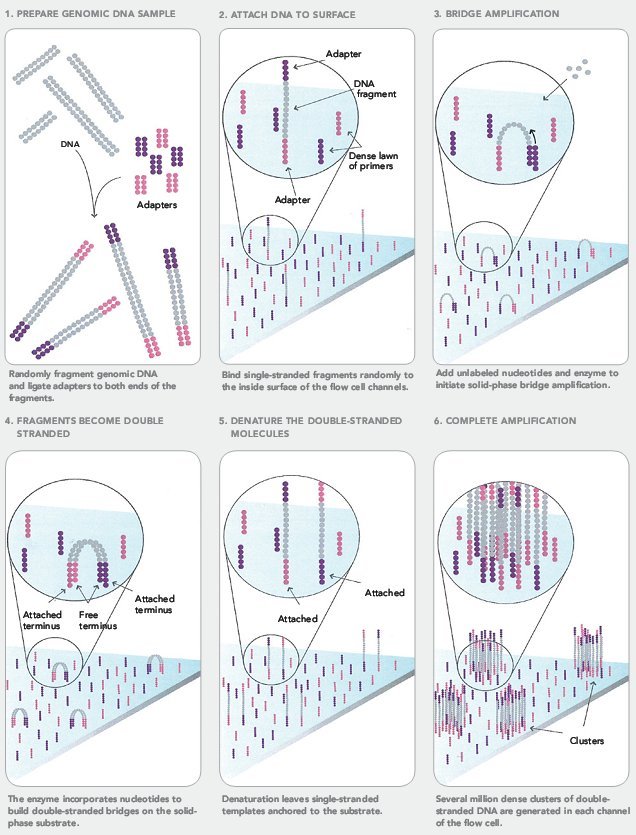
将上述的DNA样品调整到合适的浓度加入到flowcell中,再加入特异的化学试剂,就可以使得序列的一端与flowcell上面已经存在的短序列通过化学键十分强健地相连,如下图。图中不同的颜色表示的是两种不同的adpater,分别对应序列之前加入的两种adpater
连接以后就正式开始桥式PCR。首先进行第一轮扩增,将序列补成双链。加入NaOH强碱性溶液破坏DNA的双链,并洗脱。由于最开始的序列是使用化学键连接的,所以不会被洗。
加入缓冲溶液,这时候序列自由端的部分就会和旁边的adpater进行匹配。
进行一轮PCR,在PCR的过程中,序列是弯成桥状,所以叫桥式PCR,一轮桥式PCR可以使得序列扩增1倍。
如此循环下去,就会得到一个具有完全相同序列的簇,一般叫cluster。
桥式PCR的整体流程大体如下:
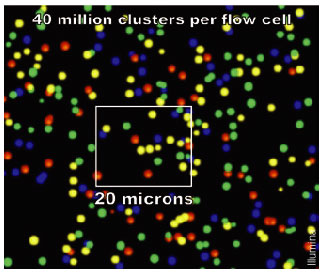
形成这种1个cluster,1个cluster的形态,在整个flowcell中看上去,示意图如下。其中的每1个cluster就算是1群完全相同的序列。
测序
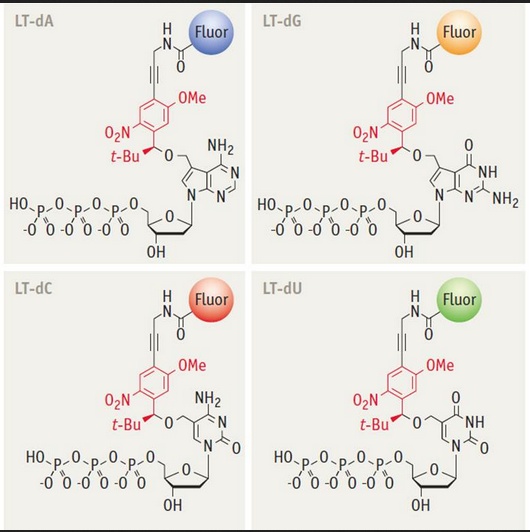
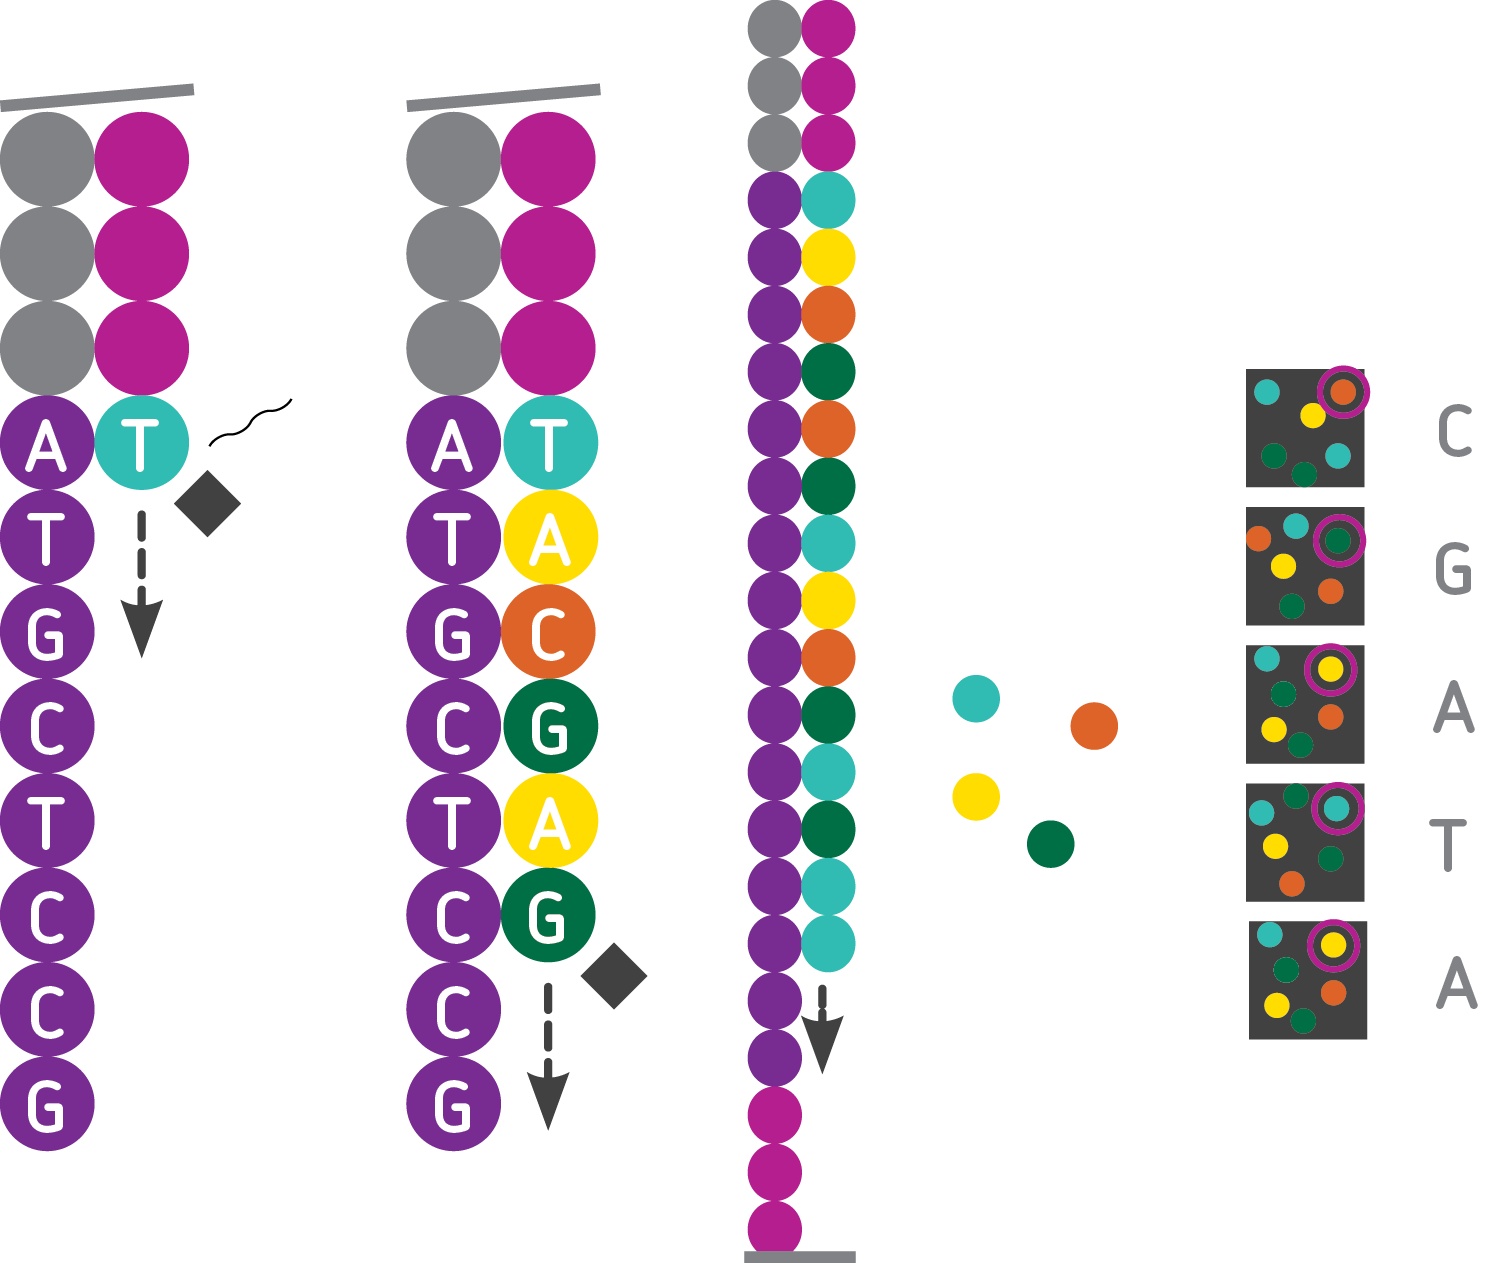
测序时,聚合酶沿模板延伸引物,加入带有可逆终止基团的核苷酸,使一轮反应主要延伸一个碱基。仪器根据荧光信号判断本轮加入的碱基,再解除终止并进入下一轮。不同代际平台的荧光编码和化学体系有所不同,不能都理解为四种碱基各自发出一种颜色。
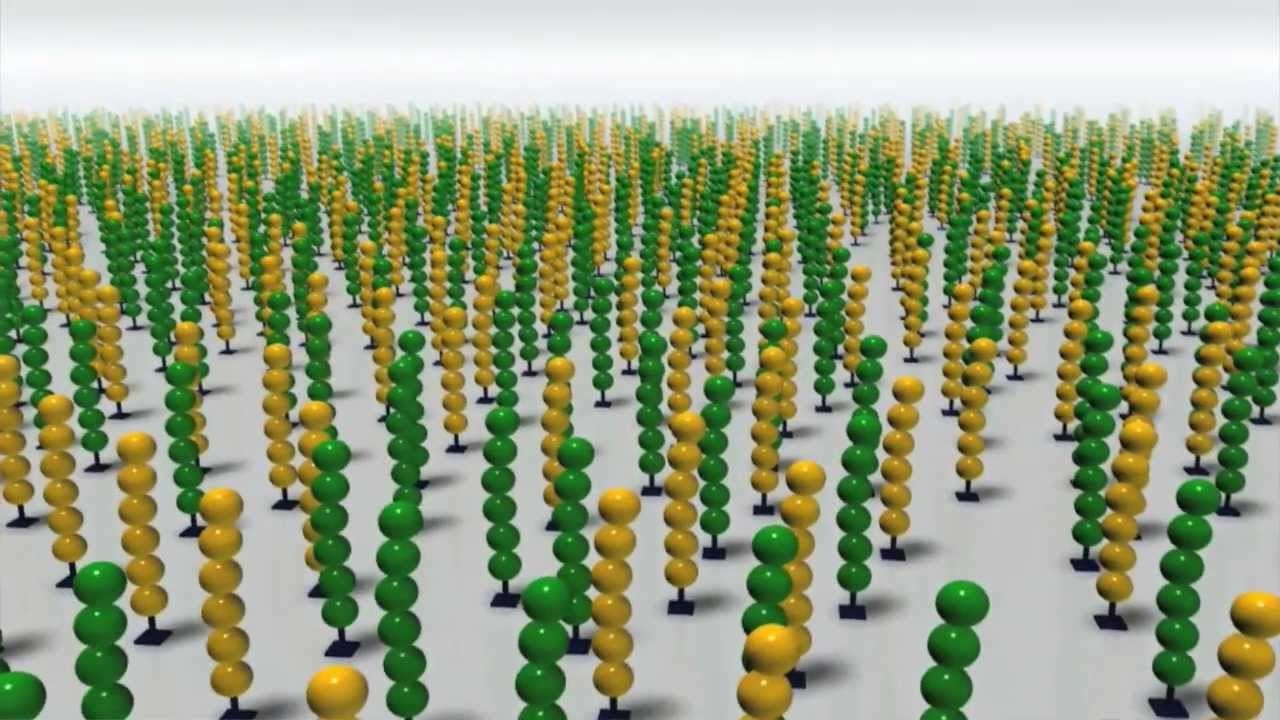
下图保留原稿的核苷酸示意图,原图来源:http://www.oezratty.net/。具体可逆终止基团以对应化学体系为准;原稿关于“−N2 叠氮基团”的说明不成立。
在测序过程中,每1轮测序,保证只有1个碱基加入的当前测序链。这时候测序仪会发出激发光,并扫描荧光。因为一个cluster中所有的序列是一样的,所以理论上,这时候cluster中发出的荧光应该颜色一致。一个测序扫描图片如下:
成像后,解除可逆终止并清除本轮检测信号,使下一轮可以继续延伸。循环进行,即可从信号序列推断碱基序列。
限制Illumina测序会有长度的原因,主要是下面2点:
测序循环中,不同模板分子的延伸可能逐渐失去同步(phasing 或 pre-phasing)。这里的测序延伸不等于反复进行 PCR。通俗一点讲,比如一开始1个cluster中是100个完全一样的DNA链,但是经过1轮增加碱基,其中99个都加入了1个碱基,显示了红色,另外1个没有加入碱基,不显示颜色。这时候整体为红色,我们可以顺利得到结果。随后,在第2轮再加入碱基进行合成的时候,就变成了,之前没有加入的加入了1个碱基显示红色,剩下的99个显示绿色,这个时候就会出现杂信号。当测序长度不断延长,这个杂信号会越来越多,最后很有可能出现,50个红,50个绿色,这时候我们判断不出来到底是什么碱基被合成。
测序过程中,使用的碱基是特殊处理的,有一个非常大的荧光基团修饰。在使用DNA ploymerase的时候,酶的状态也会受到底物的影响,其活性也越来越差。实际读长还受化学稳定性、信号质量和解码方法等因素影响,不能把所有平台归为“荧光淬灭原理”。
华大智造测序仪
待完善
修订平台特定表述和术语,不将某型号的参数写成普遍规律。
3.3 长读长与直接 RNA 测序概览
知道何时短读长不足,并正确理解长读长技术的输入输出。
PacBio
待完善
Nanopore
待完善
全长转录组测序
前文的短读长 RNA-seq 通常先把 RNA 转成 cDNA,再进行文库构建。长读长技术可以减少把一个转录本拆成许多短片段后再推断结构的困难,因此特别适合理解转录本异构体。
PacBio 的 SMRT 测序观察聚合酶合成 DNA 时的荧光信号。Iso-Seq 分析的是由 RNA 逆转录得到的全长 cDNA,不能称为直接 RNA 测序。Oxford Nanopore 则根据核酸链通过纳米孔时的电流变化推断序列,既有 cDNA 测序,也有直接 RNA 测序;其常用平台不依靠外切酶逐个切下碱基再读取。
长读长、准确度、通量和定量性能需要结合具体平台、化学版本和建库方案讨论,不能用原稿时期的单一数值概括。PacBio、Nanopore 和直接 RNA 测序的进一步比较、示例数据与练习待完善。
3.4 FASTA、FASTQ 与质量分数
能够逐行读懂原始序列文件并解释碱基质量。
碱基质量
Fastq文件对每一个碱基质量都基于ASCII码进行了打分(图3.9)。
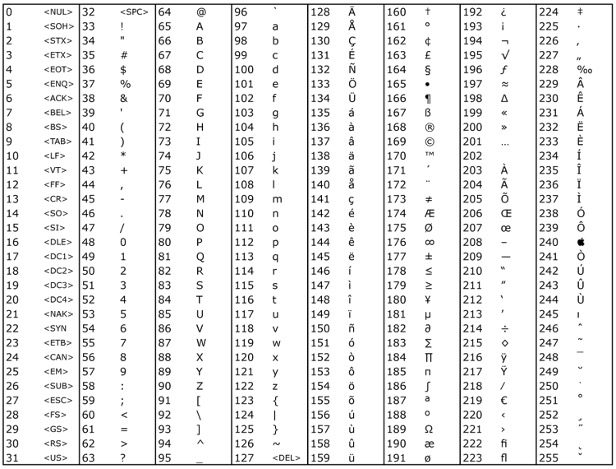
图3.9 ASCII码表
测序质量控制软件会通过碱基的Q值(Quality Score, Q)对碱基进行统计和过滤。
有两种格式Phred33和Phred64,分别代表碱基质量等于ASCII码值减去33或者64,例如:
Phred33: Phred(“F”) = 70 - 33 = 37
Phred64 : Phred(“F”) = 70 - 64 = 6
Q值是错误概率(Probability of incorrect base call, P)的对数:
Q=-10log10 P
Q值为40则代表错误概率为0.0001;为30则代表错误概率为0.001;为20则代表错误概率为0.01;为10则代表错误概率为0.01。
3.5 参考基因组、转录本与基因注释
选取相互兼容的参考资源并理解注释差异。
构建参考基因组索引
在上一步的分析中获取到的clean reads,需要将它们回帖到基因组上,在此之前,我们要建立一个基因组索引。对于有参考基因组的转录组分析,构建参考基因组索引是非常关键的一步。构建参考基因组这一步,在许多分析中,操作类似,比如之前章节介绍BWT算法时讲到的,以及后续ChIP-Seq,WGS分析中也会用到类似的操作。
RNA-Seq分析中参考基因组包括基因组DNA序列和基因组注释文件,可以从Ensemble、USCS等数据库获取。
(加一些网站图片)
GTF与GFF 文件
RNA-Seq中一个很重要的注释文件就是GTF文件或者是GFF文件。这个文件主要保存
其中基因组注释文件有两种格式,分别是GTF(General Transfer Format) 和GFF ( General Feature Format),那么这二者有何不同?其实GFF有若干个版本,GTF正是GFF文件的其中一个版本,一般认为GTF文件就是GFF 2.0版本的内容。
这两者只是一些格式细节上的不同,包含的信息内容上完全可以等价,也有很多工具可以提供两种格式的互相转换。
一个标准的GTF/GFF2.0文件需要包括9列内容(https://asia.ensembl.org/info/website/upload/gff.html):
seqname    #序列名,一般为染色体名
source     #来源,注释来源的软件名、数据库名等,没有则用“.”表示
feature    #特征类型,包括gene、mRNA、exon、CDS
start      #起始坐标位点
end        #终止坐标位点
score      #得分,该条注释信息可信度的打分,没有则用“.”表示
strand     #正负链,“+”表示正莲,“-”表示负莲
frame      #读码框,表示读码框的位置。当feature为CDS、start_codon、stop_codon时,frame值分别为0、1、2,0表示读码框在该位点进行读码,1表示读码框在该位点1个碱基后进行读码,2表示读码框在该位点2个碱基后进行读码。当feature为其他类型时,则用“.”表示。
attribute  #属性,包含众多属性。格式为“tag=value”,不同属性之间以分号相隔。
构建参考基因组索引的软件
构建参考基因组索引的软件有:BWA(Fast and accurate short read alignment with Burrows-Wheeler transform. Heng Li and Richard Burbin),Bowtie(Ultrafast and memory-efficient alignment of short DNA sequences to the human genome),Bowtie2,HISAT,HISAT2。
此外,BLASR(Basic Local Alignment with Successive Refinement)主要用于将PacBio测序的reads和参考序列进行匹配,这是一个处理三代测序的软件。用sawriter命令建库、blasr进行序列比对。
修订格式与 ID 解释,增加参考版本不匹配的排错练习。
3.6 比对、区间、信号与变异文件
建立统一的数据表示和坐标意识。
待完善
3.7 从公共数据库获得可追溯的数据
能将论文中的数据编号转化为清晰的分析输入。
待完善