附录 B — 基础问题 6—10
本组保留原题和原稿参考答案。题库目前收录 1—25 题;历史仪器参数和软件用法仍需逐项更新。
对应 质控与比对。
缩写说明
- 100 Bioinformatic Basic Questions = BBQ100
- 第6题的缩写 = BBQ100-06
B.1 BBQ100-06
问题描述
Hello 大家好!
通过前面的5个问题,我相信大家对Illumina测序,测序的储存文件格式,一些简单的建库原理已经有了一个初步的认识。那么接下来,我们就要用我们学到的知识去解决一些问题啦。
在实际操作和处理过程中,我们拿到的Illumina测序数据应该是.fastq.gz格式,其中gz表示的是使用gzip进行压缩,fastq表示使用fastq格式进行存储。获得数据的第一步,通常就是使用FastQC软件进行质控。
FastQC会对每一个输入的fastq.gz文件生成1个html网页和一个zip的压缩包。压缩包里是网页中包含的图片信息,因此我们只需要看网页里面整理好的内容就好。今天的问题围绕着FastQC的质控图来展开,请看下面2张图。
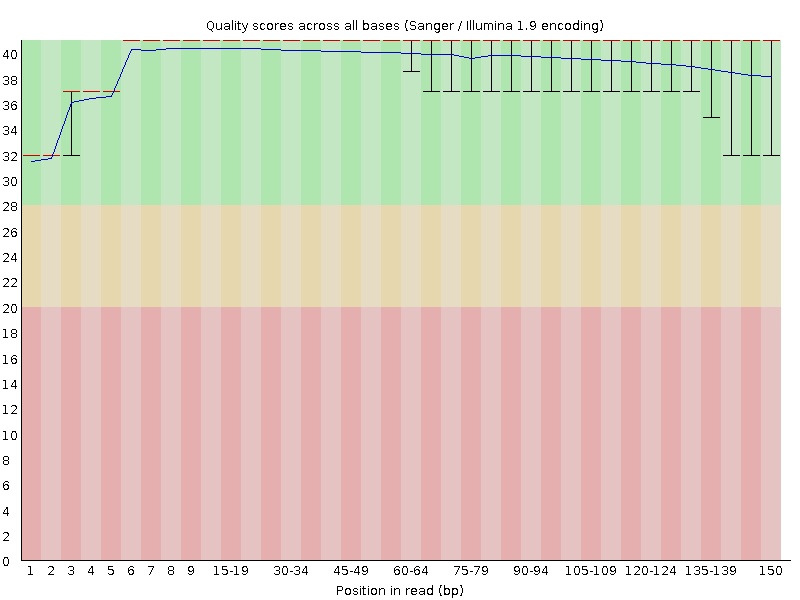
图1 - 1个Illumina测序结果, reads1 的 per-base quality boxplot
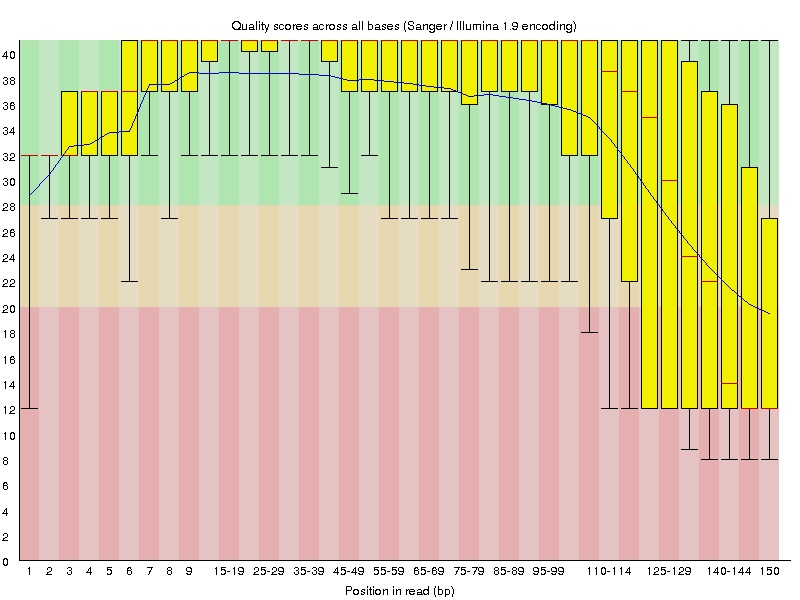
图2 - 1个Illumina测序结果, reads2 的 per-base quality boxplot
参考答案
1.图中的横坐标表示什么意思?
横轴是测序序列第1个碱基到第150个碱基.2.图中的纵坐标表示什么意思?
纵坐标表示每一bp所对应的测序质量值,
前面讲过将该碱基判断错误概率值P取log10之后再乘以-10,
得到的结果再加上pherd值对应ASCII表所得到的值就是该碱基测序的质量值;
Q = -10*log10(error P)
即20表示1%的错误率,30表示0.1%的错误率;
3.图中的蓝色线是什么意思?
蓝色的细线是各个位置的质量值的平均值的连线;4.图中的box 下面的bar , 上面的bar,箱体的下沿,箱体的上沿,箱体内部的横线分别代表什么意思?
每1个boxplot,都是该位置的所有序列的测序质量的一个统计,
上面的bar是90%分位数;
下面的bar是10%分位数;
箱子的中间的横线是50%分位数;
箱体上缘是75%分位数;
箱体下缘是25%分位数;
- - - - - - - - - - - - - -
分位数一个简单解释是:
如果一组数的25%分位数是a,意味着a超过了这组数中25%数字的大小;
5.图1与图2最主要的区别在哪里?结合我们之前的问题,为什么会出现这种情况?
相比于reads1的测序结果,图2中reads2测序质量均匀性差,准确率低;
主要原因是:
reads2的测序是在reads150bp测序完成后,
forward strands再通过1次桥式PCR合成reverse strands;在这之后再进行荧光测序;
测序质量差的主要原因是因为长时间测序结束后,合成每的活性降低,
导致合成时加不上一些碱基,最终同步性变差,主要属于phasing错误。
B.2 BBQ100-07
原题描述
Hello 大家好!
今天我们接着昨天的话题来继续进行与FastQC结果有关的提问。
我们昨天主要是针对FastQC结果中的boxplot进行了相关的探索,boxplot一般是认为FastQC几张必看的质控图之一。一般情况下FastQC的结果会包含下面几个图,而我们主要会看下图圈出来的几个。 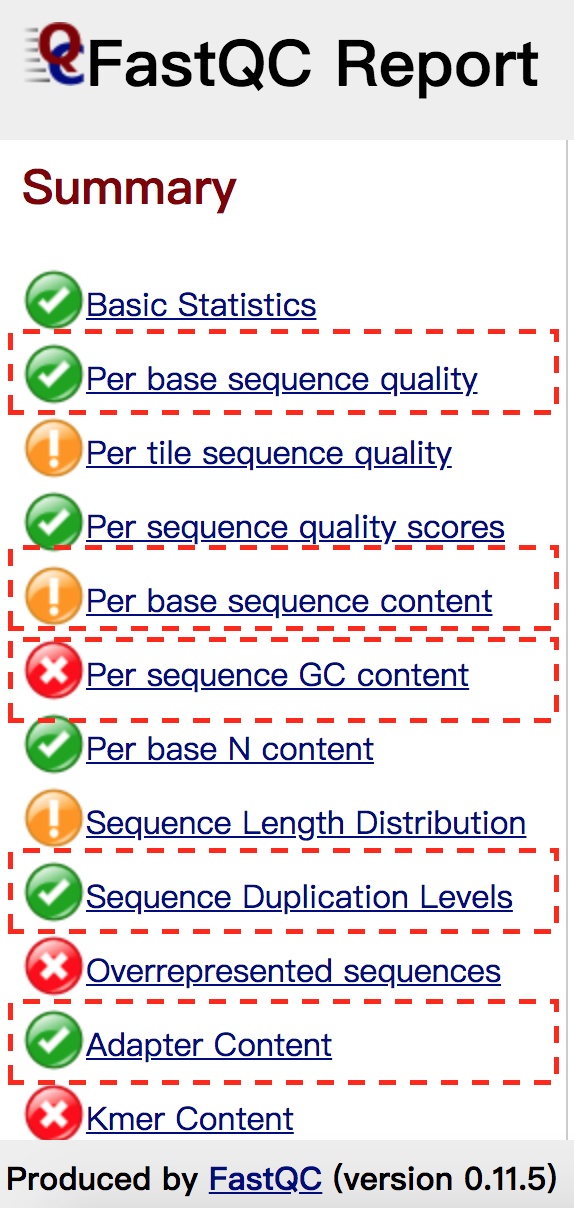
接下来的几天我们就把这些图来一个一个讨论清楚。
我们昨天讨论了“Per base sequence quality”,今天先来讨论 “Per base sequence content” 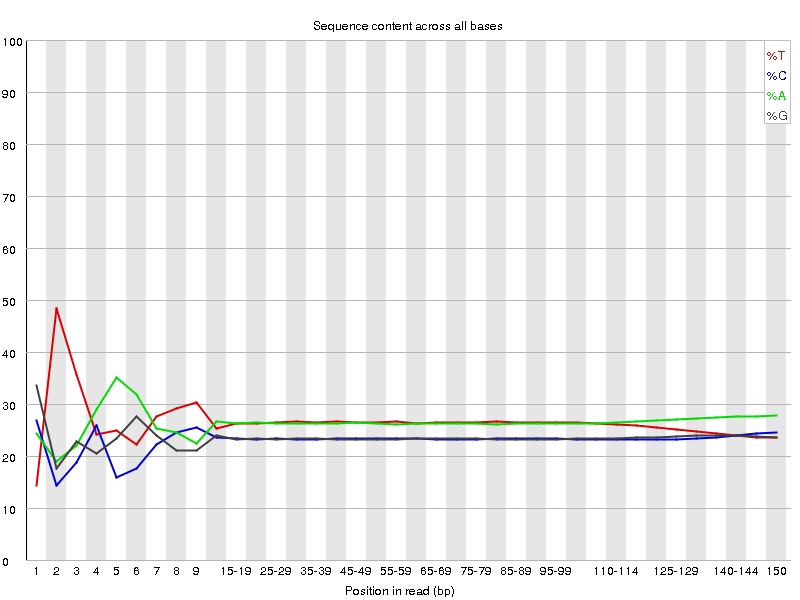
图1
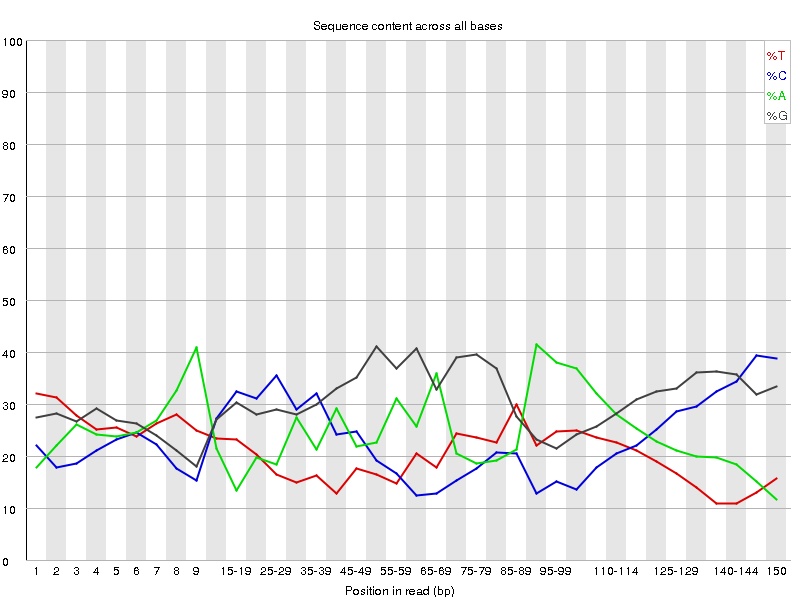
图2
参考答案
1.图1与图2中横坐标是什么意思?纵坐标是什么意思?
横轴代表1到150bp;纵轴代表ATCG在该bp的百分比。2.图1是1个正常的DNA 全基因组测序结果,为什么前面的几bp线是波动的?后面的线是平衡的?
根据Wason-Crick配对原则,A和T应该相等,G和C应该相等;
但是一般测序的时候,刚开始测序仪状态不稳定,很可能出现不平衡的情况。
像这种情况,
如果测序的得分很高,可以不进行trim开始部分的序列信息;
如果测序得分很低,需要进行trim开始部分的序列信息。
3.图2是1个特殊RNA建库的测序结果,4条线出现波动更可能是什么原因造成的?
RNA是单链核苷酸,GC或AT的含量并没有直接的关系,
4条线的波动是由于模板中ATCG的量不同导致的(就是所谓GC不平衡)。
4.在图1中你能不能看出一个恒定的量?(提示,同一物种间相同,不同物种间一般不同)如果能看出来,这个量是什么?数值大约是多少?
GC含量在同一物种中是一个恒定值。图中GC总体比例大约在42%(目测)。B.3 BBQ100-08
原题描述
Hello 大家好! 我们又见面了!
最近总搞FastQC报告的研读,是不是都看烦了?没关系,我们再搞最后2次,就进入下一个主题啦!昨天的问题中,我们告诉大家FastQC的报告中最重要的几张图都在下面用红框框出来了。 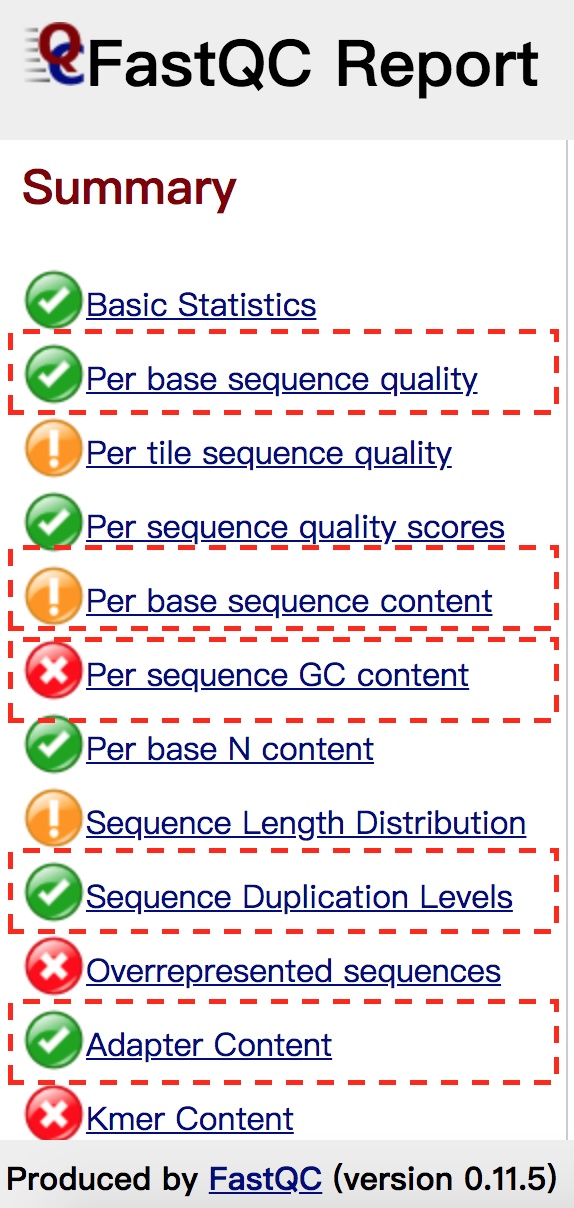
今天我们来研读2张图。 第1张图是:Per sequence GC content
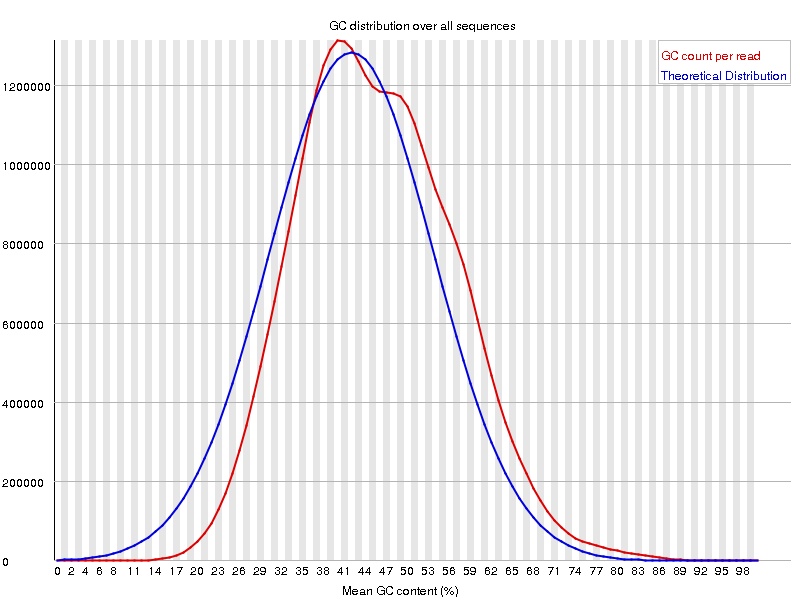
图1-1 human 全基因组测序FastQC 结果图
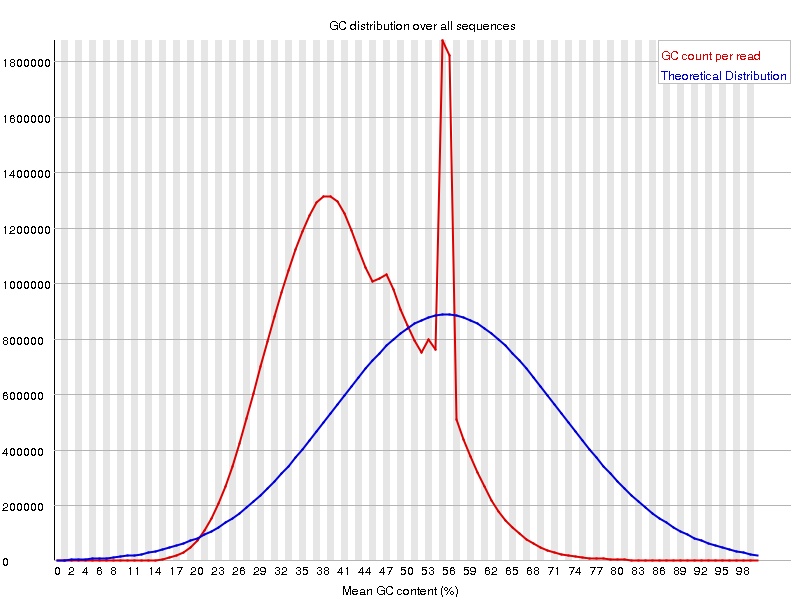
图1-2 human 全基因组测序FastQC 结果图
第2张图是:Sequence Length Distribution
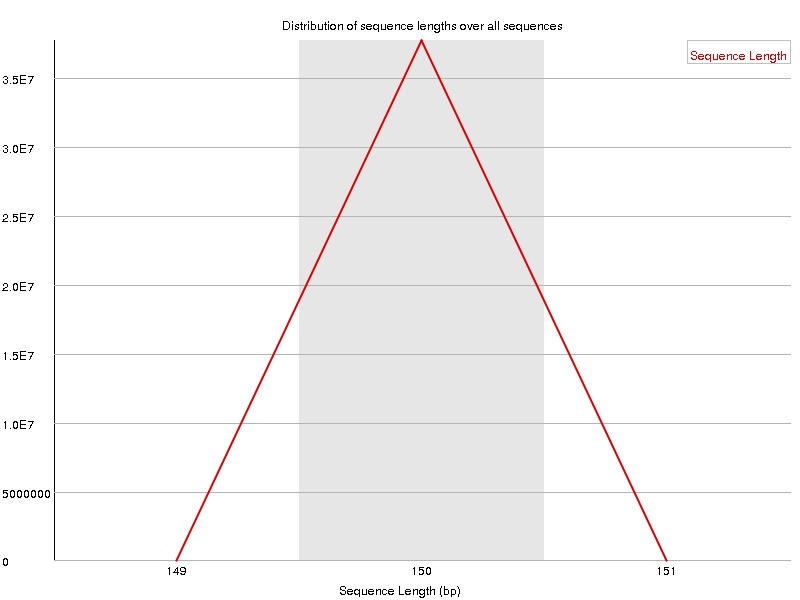
图2-1 刚下机以后的fastq数据进行FastQC 结果图
参考答案
1.图1-1 与 图1-2 中的横坐标是什么意思?纵坐标是什么意思?
横轴是0 - 100%; 纵轴是拥有相对GC含量的序列所对应的数量.2.图1-1中是human全基因组测序,结合昨天的问题,那么peak的中间大约应该在多少?
上一次的问题中GC总体比例大约在42%左右,所以如果这是human全基因组测序,那么peak在横坐标对应42的位置比较好。3.图1-2与图1-1有哪些显著的不同?造成这些不同的原因有可能是什么?遇到这个问题,我们通常应该做些什么?
图1-1有一个peak,并且与理论值(蓝线)基本重合;
而图1-2有两个,并且其中一个peak与蓝线相差很多,当红色的线出现双峰,基本是混入了其他物种的DNA序列。
遇到这个问题,首先进行mapping统计有多大比例reads map到了目标参考基因组上,如果比例非常低说明污染严重,数据不可用;
如果大部分reads都map成功,剩余一部分可以通过blast检查是混入了哪些污染物,过滤掉这些reads就可以,不影响后续的分析。
4.图2-1的横坐标是什么意思?纵坐标是什么意思?
横坐标代表序列长度,纵坐标代表长度为某一bp的序列所对应的数量。5.图2-1是刚下机的fastq数据进行FastQC 结果图,有什么特点?为什么会出现这样的结果?如果对刚下机的fastq数据进行cutadapter,图2-1还会是这样的结果吗?为什么?
测序仪成功下机的数据都是整齐的一定长度的序列,比如最常用的illumina X Ten是双端150bp;
测序过程当中产生的不足150bp的序列在下机时已经被过滤掉了;
如果进行cut adapter,序列的长度将不一致,因为reads中包含信息的insert的长度并不完全一致,
150bp的测序长度是否已经包含了adapter的序列是未知的,因此cutadapter之后的reads长度不同.
能力扩展题:
6.请想办法,计算Human genome 19(hg19)每一条染色体的GC含量。
思路1
- UCSC或Emble下载Human genome 19(hg19)染色体序列;
- 直接把下载的序列使用Fastqc检测序列“质量”,
- report中Sequence content across all bases会显示GC结果。

思路2
- UCSC或Emble下载Human genome 19(hg19)染色体序列;
- 写Python程序依次读取序列内容;
- 统计每一条染色体的GC含量;
- 具体的代码及方法可以参考知乎Live
B.4 BBQ100-09
原题描述
今天我们来详细聊聊duplicate问题。duplicate的产生主要是因为Illumina建库的过程中,一般会需要使用PCR来帮助扩增插入序列的浓度。在扩增的过程中,如果PCR扩增轮数过大,就会出现duplicate的问题,即产生一模一样的若干条序列。
FastQC中“Sequence Duplication Levels”图是用来刻画duplicate情况的。 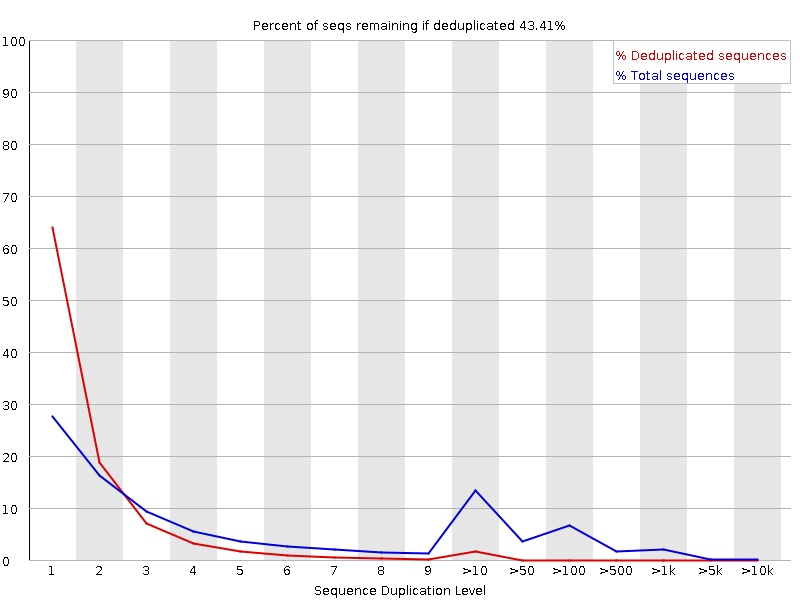
图1 duplicate结果图
参考答案
1.图1中的横坐标是什么意思,纵坐标是什么意思?
横坐标代表序列重复水平;纵坐标代表重复水平序列占所有序列的百分比。2.图1中的红线和蓝线分别代表什么意思?
红线代表去duplicate之后序列理论重复性分布(服从possion distribution 或者 binomial distribution)情况,
蓝线代表全部的序列重复性分布情况。
3.图1中的duplicate是全部序列的duplicate的情况吗?还是随机筛选了一部分?为什么要这样做?
是选择的每一个文件里前100,000条序列作为样本进行的计算,因为样本本身很大,前100,000已经能够代表样本的重复性。4.如果让你写程序,判断1个fastq文件中duplicate的比例,你的大概思路是什么?
# Python风格的伪代码:

# 第1步对序列进行排序
sort the FASTQ file by the sequence, and names as sorted_file;

# 第2步对排序的序列统计是否为duplicate
total_num = 1
duplication_num = 0

reads_1 = sorted_file.readline()
for reads_2 in sorted_file
    if reads_1 == reads_2
        duplication_num = duplication_num +1
    else
        reads_1 = reads_2
    total_num = total_num +1
print total_num
print duplication_num
能力扩展题:
5.既然谈到了duplicate的问题,那就存在remove duplicate的问题,什么情况下应该去duplicate,什么情况下不去除? (仅需要思考一下,以后我们会有专题讨论这个问题)
DNA-Seq中序列如果是随机打断需要考虑deduplicaion;酶切的样本一般不需要考虑这个问题;
RNA-Seq一般不考虑remove duplication(有paper专门讨论过这个问题);
单细胞测序需要建库过程中需要添加random barcode,且必须考虑duplication。
B.5 BBQ100-10
原题描述
Hello大家好!
我们又见面了!今天是我们的FastQC中最后1次提问啦!今天,我们要聊得是adapter与kmer的问题。
我们在生物信息学100个基础问题 —— 第5题 测序建库的adapter 的时候讨论过adapter的问题,我们知道adapter的最主要的作用是为了能够与flowcell连接,方便进行桥式PCR。那么我们的fastq文件中到底含不含adapter呢?FastQC报告就能告诉我们。
同时呢,我们今天还会讨论kmer的问题,相关的报告FastQC也会输出出来。 Part I adapter部分 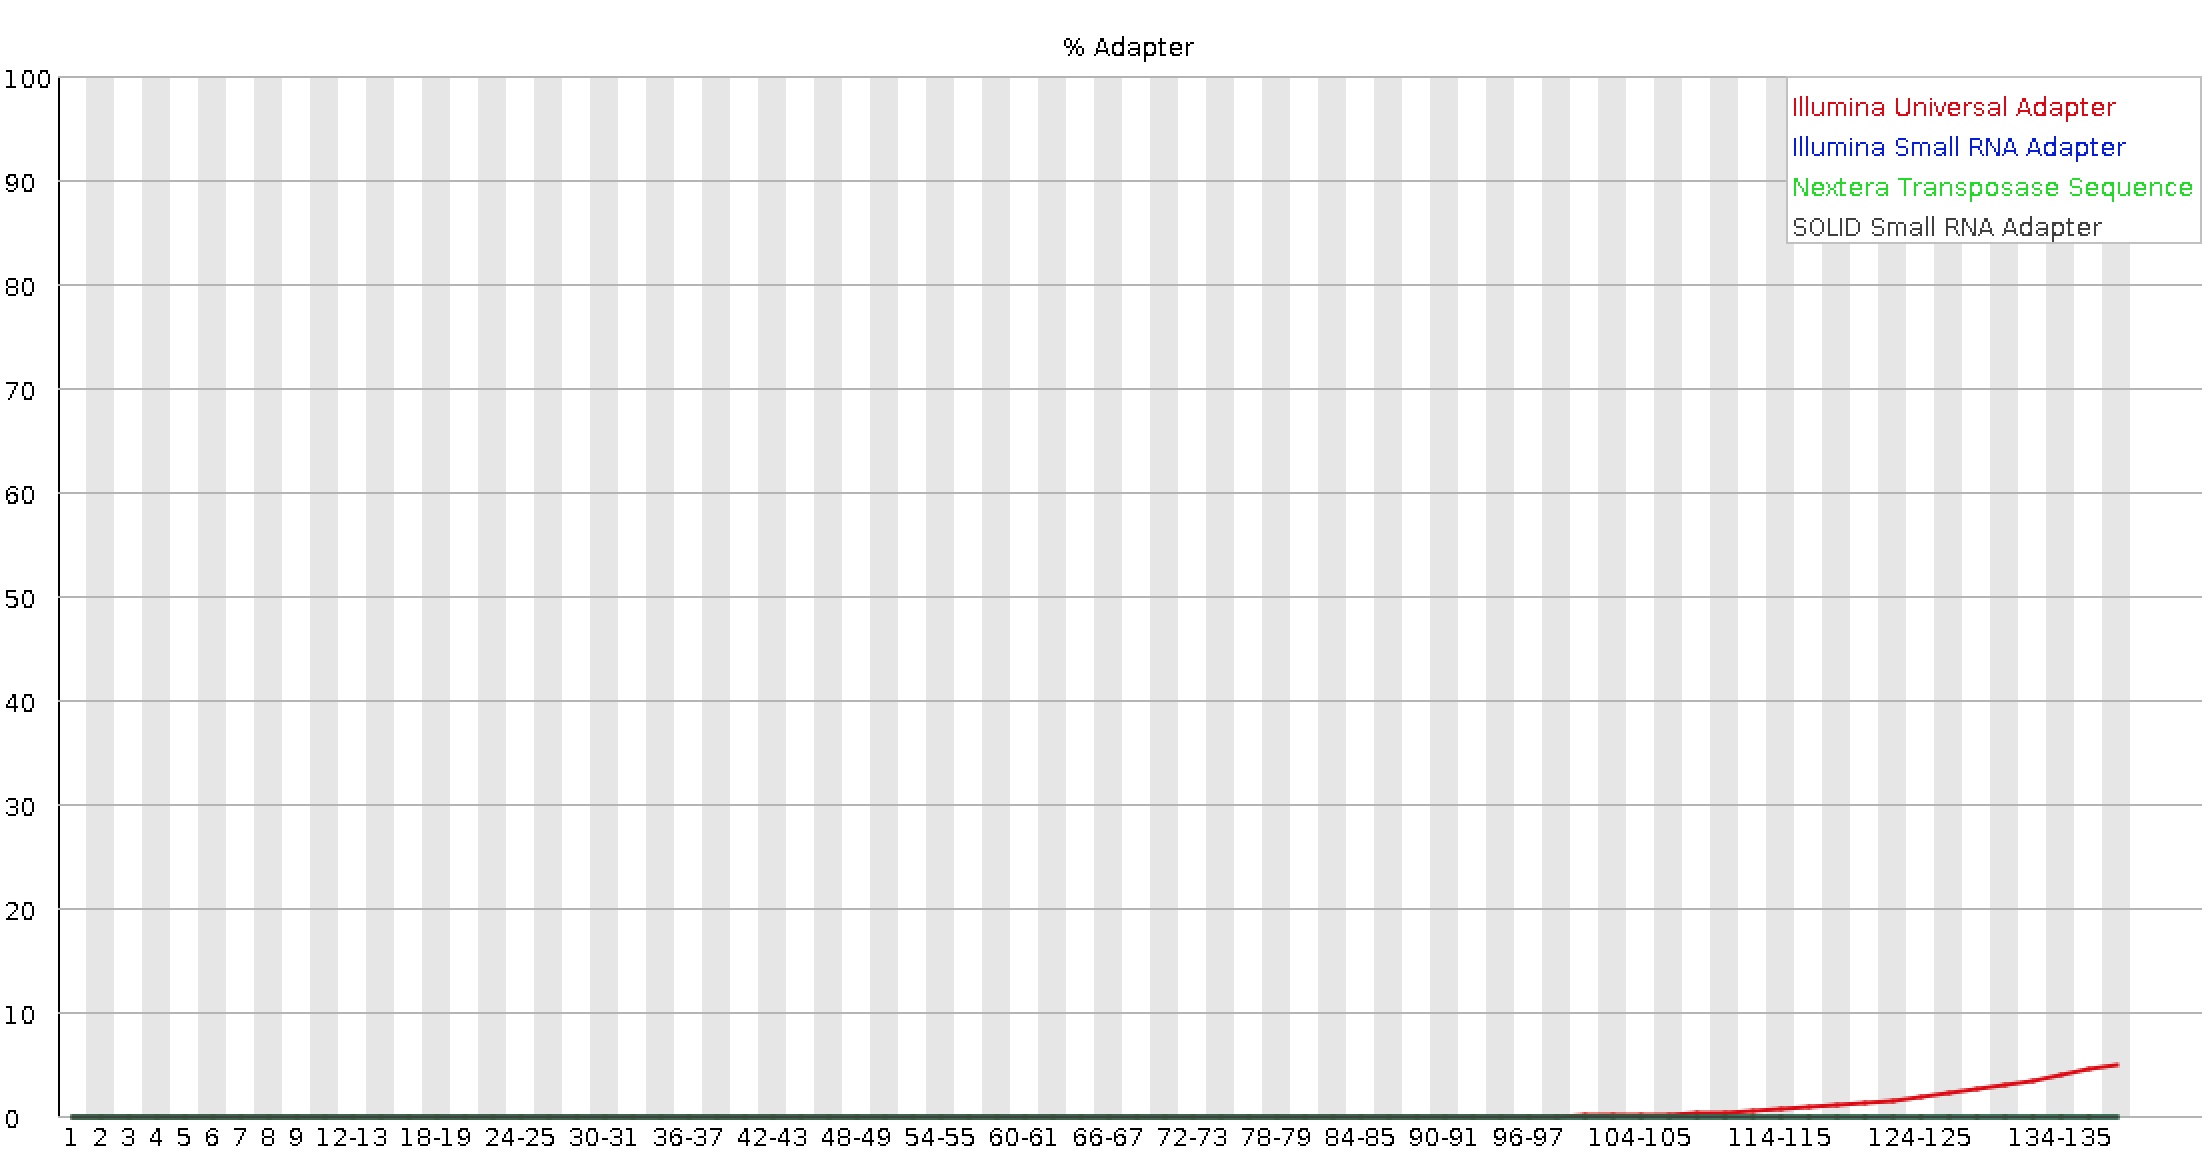
图 1-1 1个正常的adapter报告
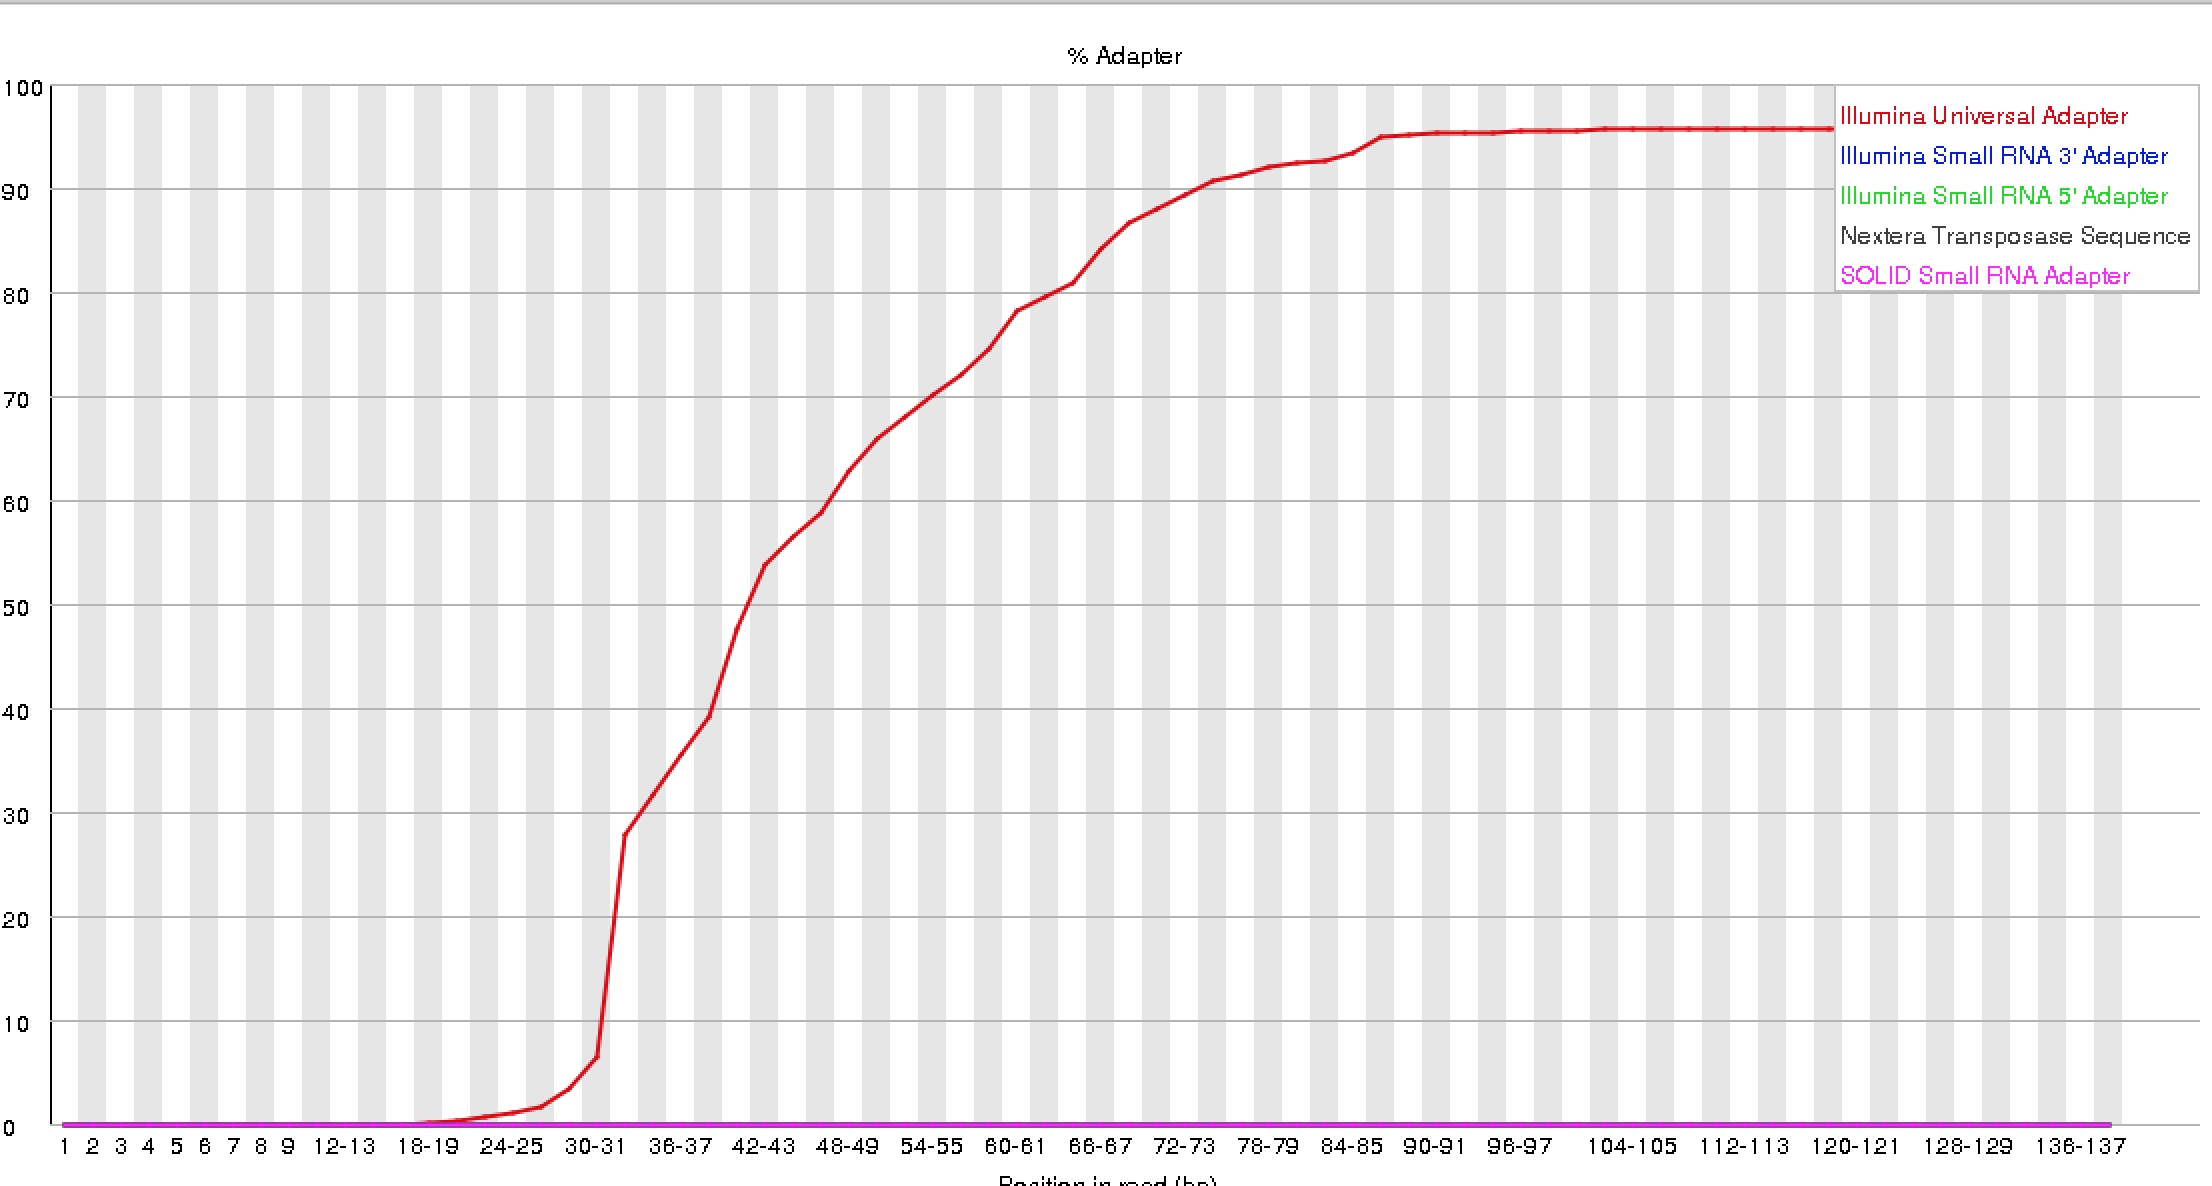
图 1-2 1个RNA-Seq的adapter报告
Part II kmer部分 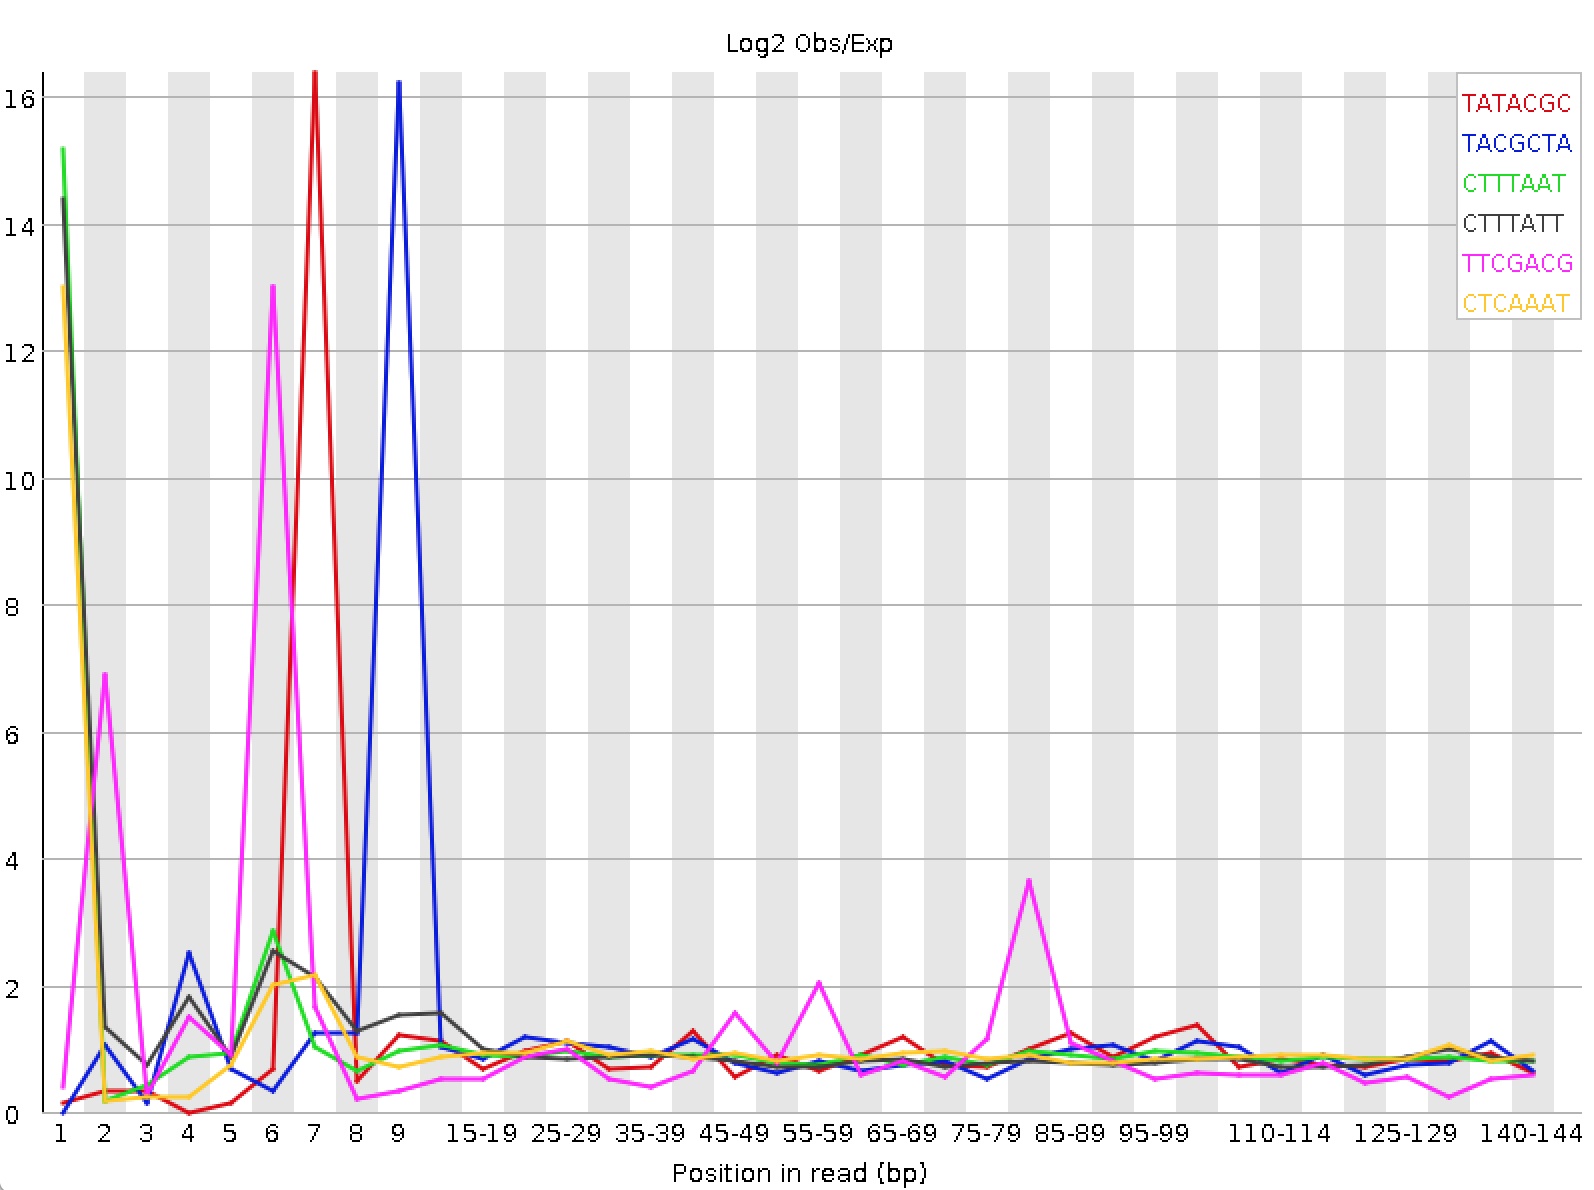
图 2-1 正常的RNA-Seq建库kmer统计
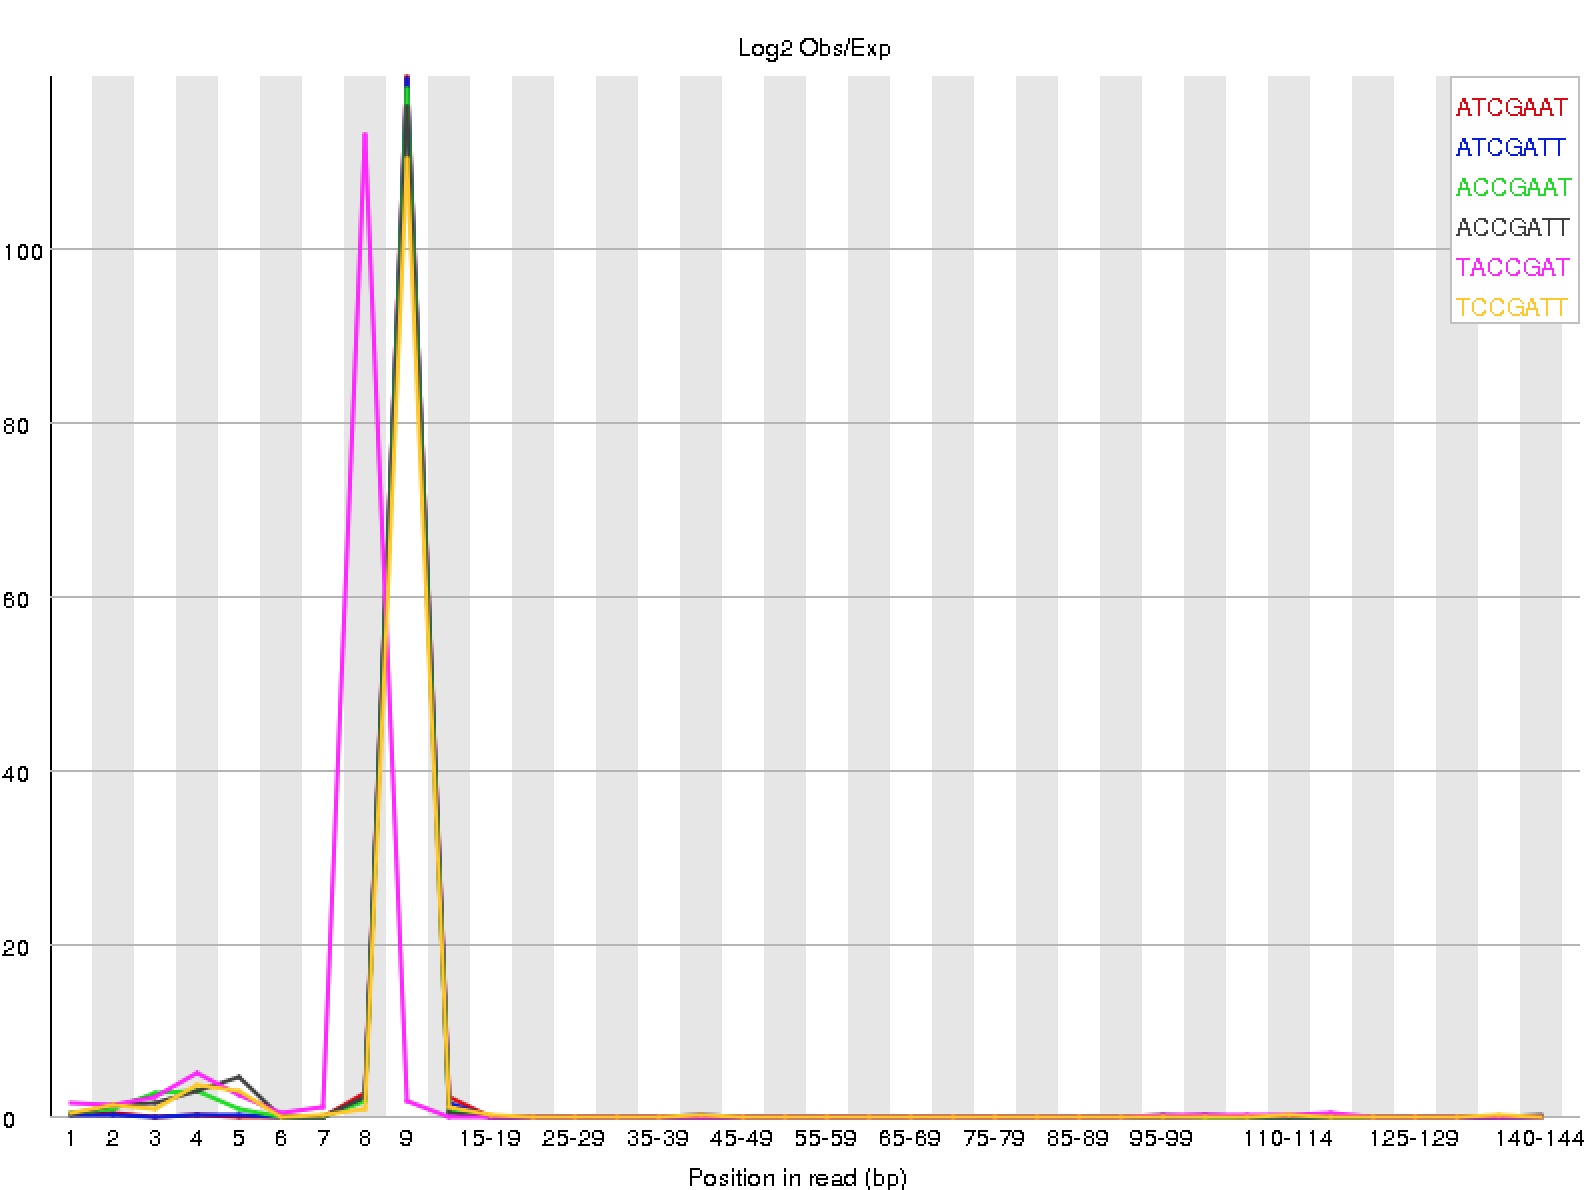
图 2-2 加入random barcode的RNA-Seq建库kmer统计
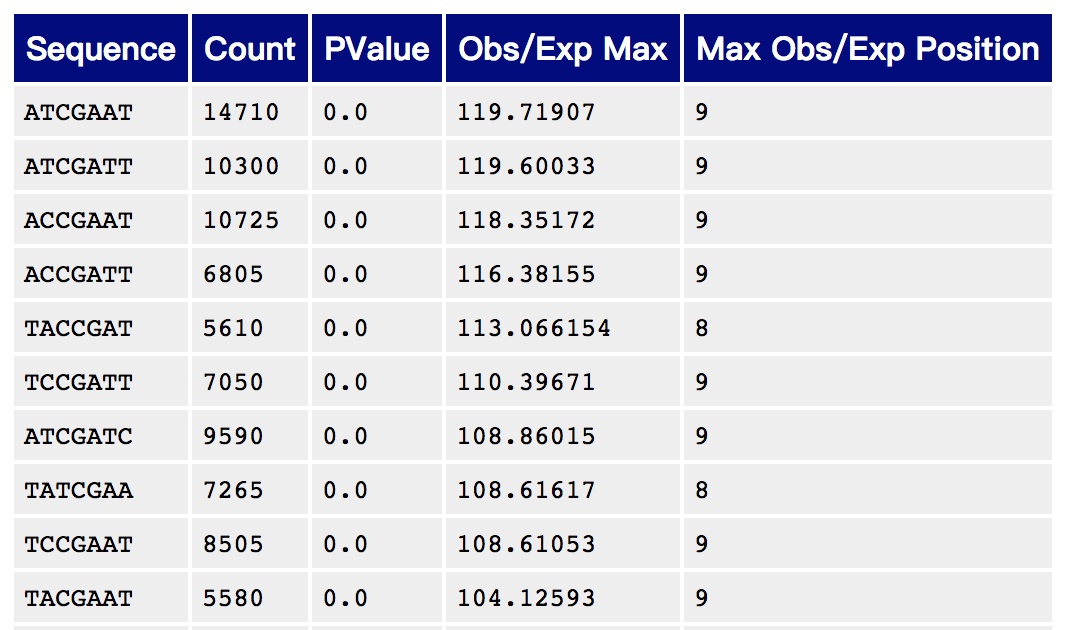
图 2-3 kmer的统计显著性分析
参考答案-关于adapter的问题:
1.Illumina的通用adapter序列是什么?图1-1与图1-2中的各种不同颜色的图例是什么意思?
Illumina Paired End Adapters (cannot be used for multiplexing)

Top adapter

    5′ ACACTCTTTCCCTACACGACGCTCTTCCGATC*T 3’

Bottom adapter


    5′ P-GATCGGAAGAGCGGTTCAGCAGGAATGCCGAG 3’

**来源**
http://bioinformatics.cvr.ac.uk/blog/illumina-adapter-and-primer-sequences/

不同颜色的图例代表不同的测序通用的adapter;
如果在当时fastqc分析的时候-a选项没有内容,则默认使用图例中的通用adapter序列进行统计。
2.图1-1与图1-2中的横坐标与纵坐标分别是什么意思?
横坐标代表reads中的位置,纵坐标代表adapter序列含量的百分比。3.图1-1与图1-2中最显著的差异是什么?如果两者都是RNA-Seq的数据,哪个可以继续下游分析,哪个不能够进行下游分析?为什么?
图1-1的结果表明少量的序列3'端测到了少部分adapter序列,且测序时使用的是红色图例代表的adapter;
图1-2的结果表明测序时使用的是红色图例代表的adapter;除了前20bp,reads后半段序列有很高比例都是adapter,建库可能存在问题。
参考答案-关于kmer的问题:
4.kmer就是一定长度的序列,比如AATTCCGG就可以叫做8-mer。那么图2-1余图2-2中的横坐标什么意思?纵坐标什么意思?
横坐标代表短序列的长度,纵坐标代表某长度的短序列在所有reads中所出现的频率百分比。5.图2-1与图2-2中哪个kmer问题比较严重?为什么?
图2-2的问题更严重,因为该图中kmer的出现位置集中且数量较多,可能是加入了random barcode,出现了duplication问题。6.图2-2中是在reads的5’端加入了约10bp左右的随机序列,结合 生物信息学100个基础问题 —— 第9题 读懂FastQC报告中的duplicate问题 这样做的目的是什么?
一般在进行RNA—Seq测序时是不会进行remove duplication;
但是一些比较特殊的建库流程比如说单细胞RNA-Seq测序时PCR扩增轮数较多,可能出现大量的duplication;
对于这些建库方法,通常需要添加random barcode,然后需要根据random barcode进行remove duplication。
7.思考题:图2-3是FastQC生成的kmer是否显著的统计报告。其中的每一列是什么意思?这个统计显著性检验计算的p-value是使用什么方法计算的?
- 第一列:kmer内容
- 第二列:kmer在序列中某一位置出现的观测数量
- 第三列:二项分布统计检验P-value
- 第四列:kmer在某一位置的观察值与理论值的比值
- 第五列:观察值与理论值比值最高值出现的位置