附录 D — 基础问题 16—20
本组保留原题和原稿参考答案。题库目前收录 1—25 题;历史仪器参数和软件用法仍需逐项更新。
D.1 BBQ100-16
问题描述
Hello大家好!我们又见面了!
在这之前,我们一直在讨论怎么去做FASTQ文件的质控,怎么trim,怎么cutadapt;还为大家介绍了从双序列比对的最根本的原理及算法;再到后来学习了低通量的找相似序列的办法BLAST以及基因组快速定位的办法BLAT。那么从今天开始以后的若干问都是与高通量测序结果的回贴(mapping)问题有关。
首先来看一下技术路线图:
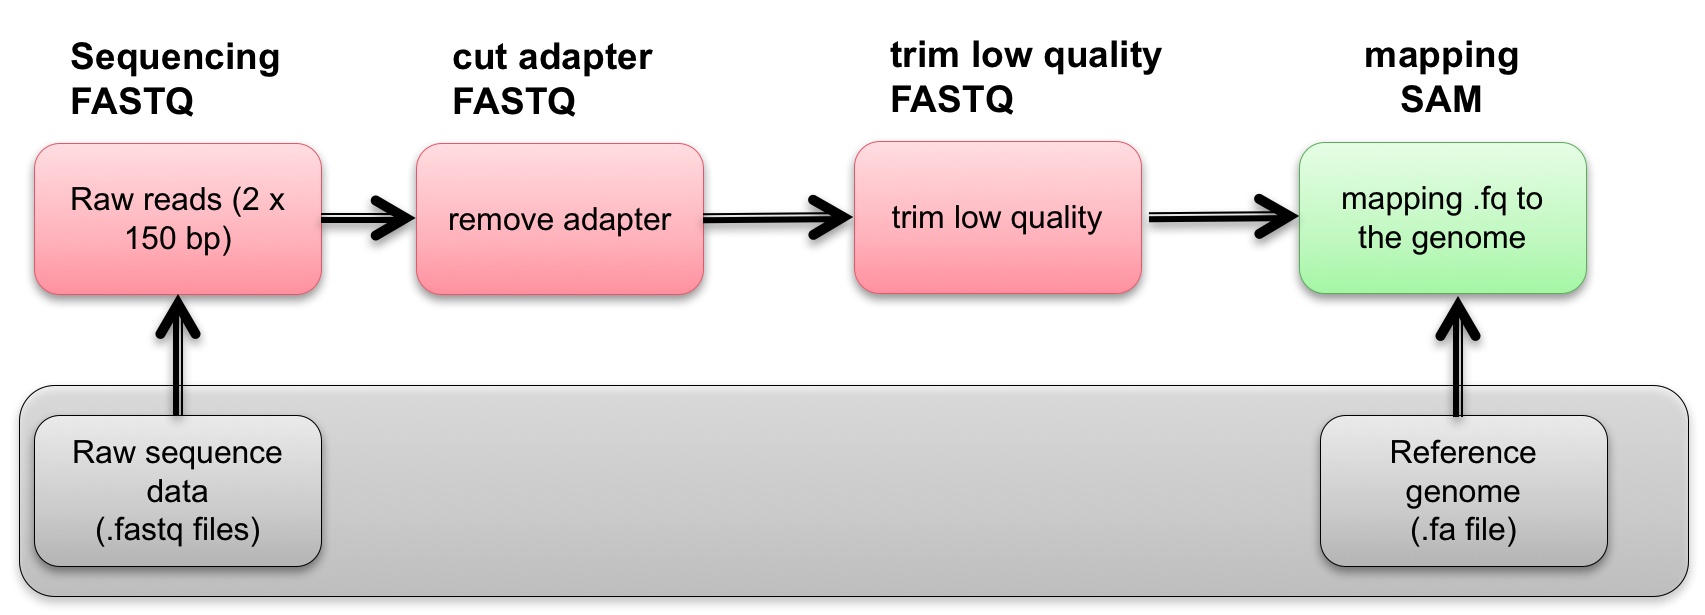
图1.从FASTQ到SAM路线图
我们的核心任务是从FASTQ文件开始,经过中间的质控,最终找到序列在基因组上的定位。
那么,我们之前的算法和方法能不能高效完成这个问题呢,答案是不行的!因为这次我们的输入常常是10^7 甚至更多的reads,而且是要在全基因组上寻找定位,比如人的基因组有3Gbp大!所以如果不优化算法,估计mapping这个问题就要等到地老天荒。关于mapping的算法问题,我之前录过1期视频,专门推导了为什么应用BWT算法就可以完成我们这项艰巨的任务。
踏踏实实做技术:BWA,Bowtie,Bowtie2的比对算法推导
谈完了算法,我们再谈谈比对软件。目前市面上针对DNA测序的结果mapping的比对软件有很多。针对2代测序优化过的,最常用的有Bowtie,Bowtie2,BWA这三款;针对3代测序优化的比对软件有BLASR,LAST,BWA-MEM等等。因为目前二代测序占据了90%以上的市场份额,因此我们前期主要讨论的内容是二代测序的比对问题,也就是Bowtie,Bowtie2,BWA这三款软件。
其实,看过我上面BWT推导的朋友应该能够知道,这三个软件本质上的算法是没有区别的,有区别的地方都是小修小改。所以上,理解了其中的1个,其他的也都很好理解。我们会发现,这些算法的最基础的要点就是都要有1个index。那么什么是index呢?简单来说就是若干个文件,方便我们快速地访问及搜索基因组。上面我说的这些比对软件都需要建立index。
一般建立index的输入文件为参考基因组序列(FASTA格式)和1个我们指定的index-name;输出为若干个以index-name为开头的index文件。比如我们使用Bowtie2,以human reference genome建立index的命令为:
build-index by Bowtie2
> bowtie2-build hg19_only_chromosome.fa  hg19_only_chromosome &
解释
> bowtie2-build为建立index的命令,安装bowtie2以后就可以用;
> hg19_only_chromosome.fa 为human genome的参考基因组,FASTA格式;
> hg19_only_chromosome 为建立index需要指定的名称; 最终建立index输出结果如图2:
图2.使用bowtie2建立的human genome index
那么今天的任务是,请观看我的两个视频:
第1个视频是介绍BWT算法的及推导的;
视频链接:
踏踏实实做技术:BWA,Bowtie,Bowtie2的比对算法推导;
第2个视频是介绍怎么从UCSC genome browser上下载参考基因组然后构建index的;
视频链接:
高通量测序技术交流录像 请观看视频的 24:45 - 41:00部分,参考基因组的下载与bowtie2 index的建立
参考答案
那么我们今天的问题是:
1. 为什么FASTQ文件的快速比对需要建立index?
主要是为了加快比对速度,Index简单来说就是若干个文件,方便程序快速地访问及搜索基因组;
在Index的帮助下,比对软件可以把序列比对的问题的时间复杂度降低。
2. 如果我从1个网站上下载的是1个物种的参考转录组的序列,其中包含了A,U,C,G碱基,我的FASTQ为该物种转录组测序的结果,用A,G,T,C,4种碱基来表示。那么需不需要在建立index之前把参考转录组中的U全部都换成T?
需要转化,因为比对程序并不能将U直接识别为T。3. 请在Linux环境下,下载human genome 19参考基因组的1号染色体序列;并使用bowtie建立index。
- 下载 human genome 19参考基因组的1号染色体序列
> weget -c -o ./test http://hgdownload.soe.ucsc.edu/goldenPath/hg19/chromosomes/chr1.fa.gz &
# -o,将文件下载到指定目录中
# -c,断点传续
# &,后台运行- 下载得到的文件为 chr1.fa.gz,压缩格式,解压文件
> gzip -d ./test/chr1.fa.gz - 解压得到chr1.fa,下一步建立Index
> bowtie2-build ./test/chr1.fa ./test/chr1_bowtie2_index &- 得到
chr1_bowtie2_index.bt2,注意,调用index时使用的名字为chr1_bowtie2_index
D.2 BBQ100-17
问题描述
Hello大家好! 我们今天又见面了!
经过了1个小长假,不知道大家的生物信息学100问作业写得怎么样了?
对了,告诉大家一个好消息,我们的生物信息学基础100问终于有了一个好的名字,叫100 bioinformatics basic questions , 简称BBQ100,大家以后要记住这个名字哟!
我们从第16题开始,正式接触了高通量测序mapping的内容,可能有的朋友又忘记了mapping的定义,我们再来回顾一下这个概念。
“比对“对应的单词是alignment,往往特指低通量的序列之间的比较。比如10条序列,进行多序列比对就是我们常说的 multiple alignment问题;如果是2条序列的比对,我们经常称其为pairwise alignment.
“回贴”通常对应的单词应该是mapping,一般指高通量的数据去寻找基因组的位置。比如我们进行测序以后,有10^6对 read pair,要去寻找他们在基因组上的位置,这个时候就是一个典型的mapping问题。
我们再把思路理清楚,在进行mapping的时候,
输入文件应该包含:
1. 测序结果(通常是FASTQ或者是FASTQ的压缩文件)
2. 之前建立好的参考基因组的index文件(不同的mapping软件建立的方法大同小异,但一般都是提前构建)
输出文件应该包括:
1. 比对的结果文件(一般是SAM文件格式或者是BAM文件格式)
2. 比对的情况报告
今天我们就要谈一谈SAM/BAM文件格式。
首先先说二者之间的关系,BAM文件是SAM文件的压缩格式,压缩以后可以节省空间,排好序的BAM文件还可以提供随机访问功能,性能优良。但是BAM文件和SAM文件储存的内容是完全一样的。我们以后还要单独再说BAM文件的操作方法,今天我们把重点放在文件中的内容上。
SAM文件的全称是:Sequence Alignment Map,它设计之初就是为了存储mapping结果的。一个标准的SAM文件由2部分组成,第1部分是以“@”开头的头部,在文件的最前面;第2部分就是紧跟在头部后面的比对结果文件。我们先来看一个例子(图1)。
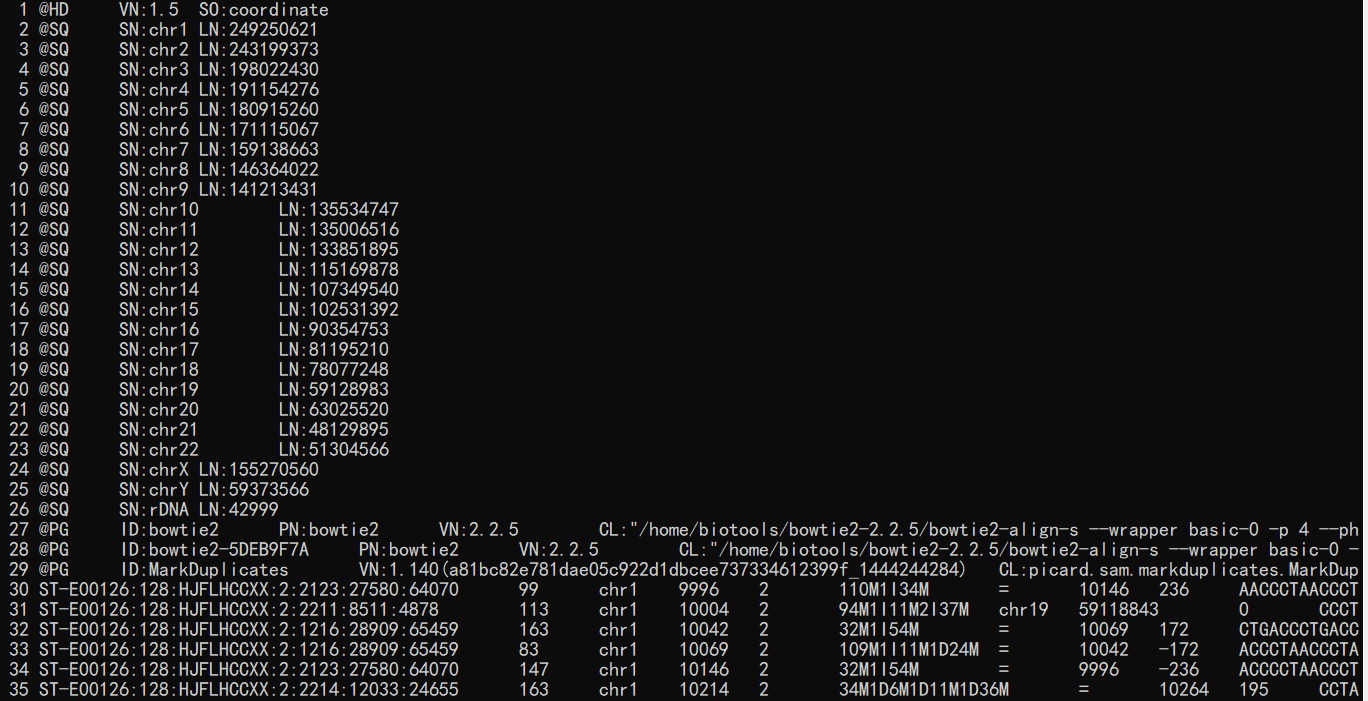
图1 SAM文件的内容
在Linux中,访问sam文件最好用的工具是samtools,常用的操作如下:
# 假设SAM文件的文件名是 test.sam

# 1.只查看头部
samtools view -H test.sam

# 2.只查看内容,不查看头部
samtools view test.sam

# 3.查看头部内容
samtools view -h test.sam

# 4.查看帮助文档
samtools view
另外,通常情况下,1行SAM文件的内容包含有多列,标准的SAM文件会包含11列内容,其中每一列的内容代表的意思与简单的描述如下。我们今天主要关注的是前面4列内容。
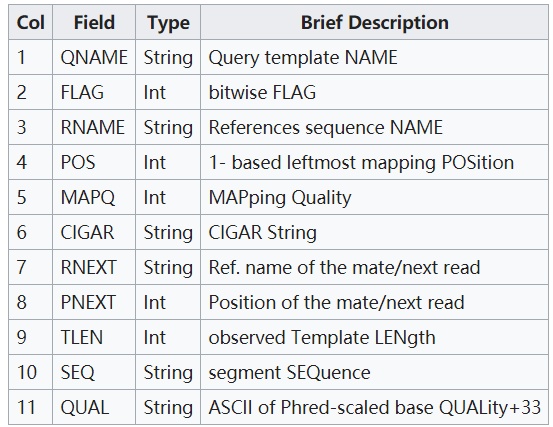
图2 标准SAM文件中的11列内容代表的含义
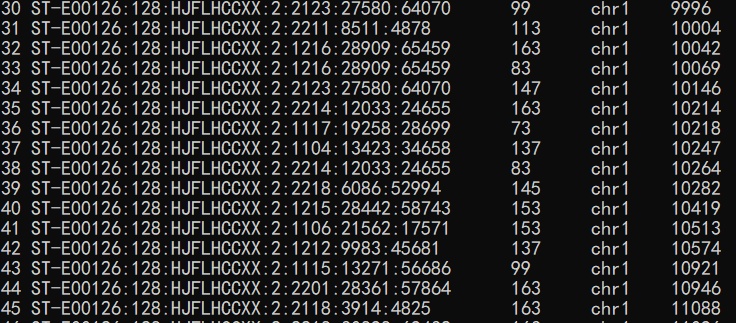
图3 SAM文件中的前4列内容
参考答案
说了这么多,那么我们今天的问题如下:
1. SAM文件的头部内容中常见的标志符号有@HD,@SQ,@PG,请问这三者后面跟随的信息分别是什么意思?
- 这三者都属于注释信息;
- @HD:说明符合标准的版本、对比结果是否进行了排序
- @SQ:参考序列说明
- @PG:得到的文件都经过了哪些处理,比如mapping的详细程序等等;
2. 图3是SAM文件内容的前4列(最前面的序号是我加上去的,不包含在SAM文件中),那么请你解释一下这4列分别代表什么意思?其中的FLAG是第几列,是什么意思?
- QNAME:比对片段的编号;以及read name,通常包括测序平台的信息;
- FALG:比对情况的代表值,也叫做位标识,每一个数字代表一种比对情况,这里的值是符合情况的数字相加总和;
- flag取值:
1(1)该read是成对的paired reads中的一个
2(10)paired reads中每个都正确比对到参考序列上
4(100)该read没比对到参考序列上
8(1000)与该read成对的matepair read没有比对到参考序列上
16(10000)该read其反向互补序列能够比对到参考序列
32(100000)与该read成对的matepair read其反向互补序列能够比对到参考序列
64(1000000)在paired reads中,该read是与参考序列比对的第一条
128(10000000)在paired reads中,该read是与参考序列比对的第二条
256(100000000)该read是次优的比对结果
512(1000000000)该read没有通过质量控制
1024(10000000000)由于PCR或测序错误产生的重复reads
2048(100000000000)补充匹配的read
3. 如果1条序列的FLAG=83 (图3标号38的行)请解释其比对含义。
使用Explain SAM Flags工具,结果如下:
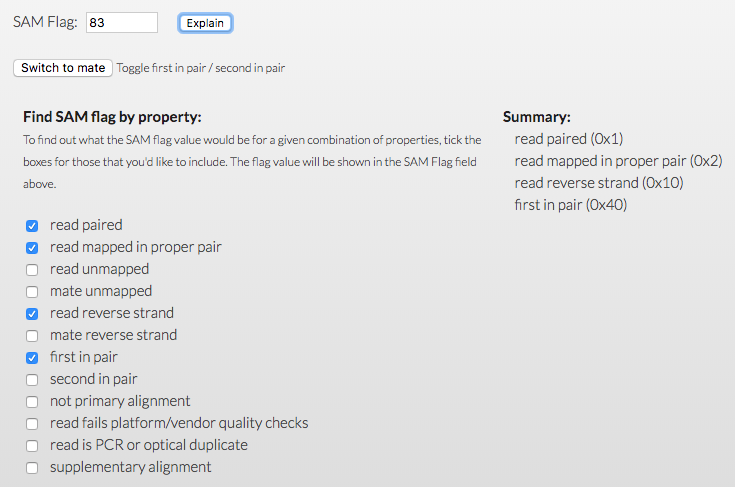
FLAG = 1+2+16+64=83 ,不同数字对应的解释如上。即当FLAG=83时,这代表着:
(1)序列是双端测序的结果;
(2)mapping的结果正常;
(3)reads mapping到了genome的负链上;
(4)此reads为reads1
参考资料:
D.3 BBQ100-18
问题描述
Hello 大家好! 我们又见面了!
今天我们接着昨天的内容,为大家介绍一下比对的质量MAPQ。
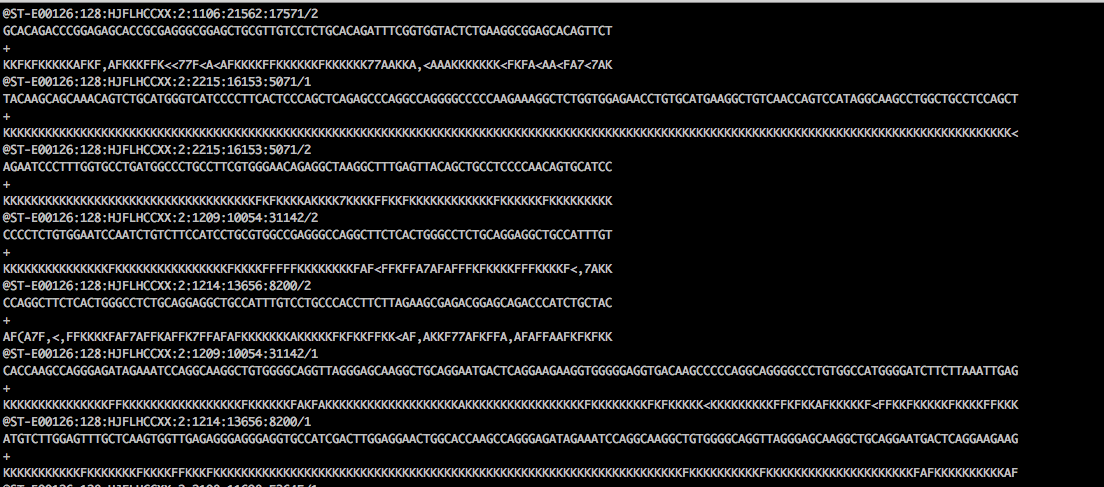
在我们BBQ100的第1问中,我们就问了大家一个问题FASTQ格式中的第4行记录的是什么内容。我们也给大家进行了解答,FASTQ格式的第4行记录的是每一个碱基的测序质量信息,也叫phred值。1个FASTQ记录的例子如下:
@HWI-ST1350:124:C1C2TACXX:3:1101:1223:2042
CTTTTCGAGTCAGACACATGACAGCCGGCAGCAACTGGAATGGCAGCAATT
+
BBCFFFFFGHHHHJJIJJIIJJJJIJJJGIJIIJJIJIGIIJJGIIIJIIG
我们在mapping的时候,会遇到一个问题,比如就用我们上面给大家展示的FASTQ序列举例。如果这条序列(readA)最终可以比对到:1号染色体的100000这个位置,但其中包含了1个mismatch(错配);或者是2号染色体的200000这个位置,但是有2个错配。那readA到底是比对到第1个位置还是第2个位置呢?
这个时候就需要1个度量值来帮我们做判断,选择1个最好的作为最终的比对结果(当然研究一些比较特殊问题的时候需要把相似的比对结果都输出出来),这个度量值就是MAPQ。
那么MAPQ是什么意思呢? 根据SAM文件的官方定义:
MAPQ: Mapping Quality. It equals  -10 log10 Pr{mapping position is wrong}, rounded to the nearest integer. A
 value 255 indicates that the mapping quality is not available.
简单翻译一下:MAPQ是mapping的质量值,计算方法与FASTQ的质量值类似,
MAPQ=-10 * log10{mapping出错的概率}当MAPQ=255的时候,代表MAPQ没有意义,就是一个占位符。
那么怎么计算MAPQ呢? 到了这里,可能又会有同学问了,虽然我们知道了MAPQ的含义,但是里面有一个mapping出错的概率,我应该怎么计算呢?这是一个非常容易问到的问题!
而我的回答是:根据mapping的情况,然后结合碱基的测序质量值进行评估。核心思想是,低质量的碱基如果进行了mismatch(错配),那么很有可能是测序错误导致的,不应该罚太多分;低质量的碱基如果与参考基因组完美match(匹配),那么也很有可能是测序错误导致的,不应该加太多分。
以我们下面的图1内容为例,第5列是MAPQ值,一般在后续分析的时候,我们都需要把MAPQ质量过低的reads去掉,一般的cutoff是MAPQ≥10,严格一些的比如去寻找somatic mutation的时候需要MAPQ≥30.
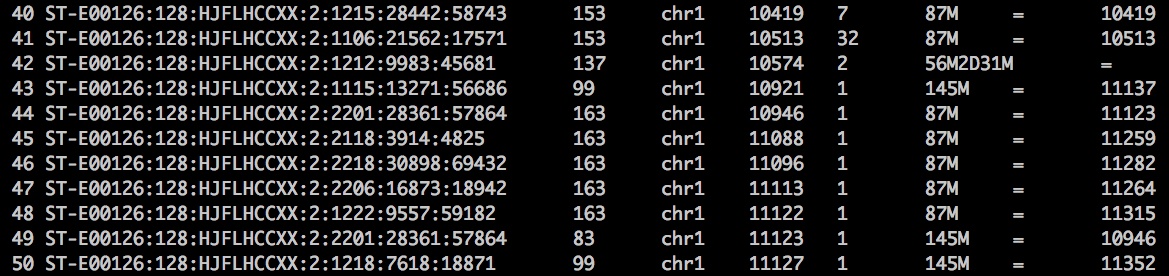
图1 标准的SAM文件截图
参考答案
好了,说了这么多,我们今天的思考如下:
1. 如果mapping的时候输入的是FASTA文件,那么MAPQ还有意义吗?为什么?
没有意义。FASTA不包含测序质量信息,因此最后的MAPQ无法计算,也没有意义,常用255代替。2. 不同的比对软件比如bwa与bowtie2,计算出来的MAPQ意义相同吗?为什么?
BWA与Bowtie2的核心算法相同,但是比对策略和最终判断输出结果的评价体系不同。
MAPQ虽然代表的均是mapping的质量值,但是不同算法软件间的MAPQ不能同时比较。
简单来说,我们不能认为BWA 中 MAPQ=42就要好于Bowtie的MAPQ=40,反之亦然!
3. 请写出samtools view 命令获得MAPQ大于等于20的sam文件,假设原始的sam文件名为raw.sam,过滤后的sam文件名为filter_MAPQ20.sam
samtools view -S -q 20 ./raw.sam > ./filter_MAPQ20.sam
# -S input is sam file;
# -q INT minimum mapping quality ;
运行结果: 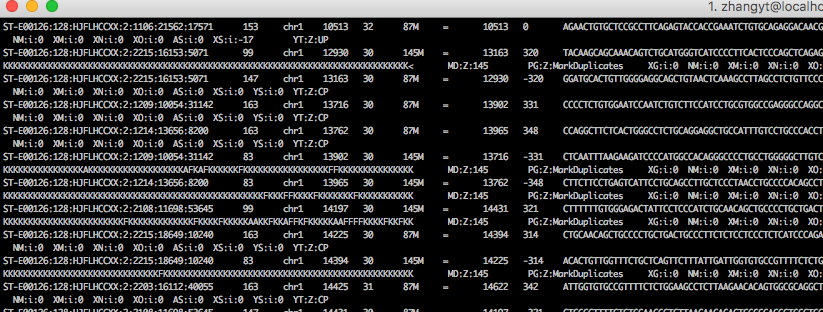
答1 质量值均高于20
大家在看了我们的BBQ100活动以后,也不要忘了支持我们的知乎Live!
D.4 BBQ100-19
问题描述
Hello大家好!我们又见面了!
今天我们来和大家一起继续学习SAM/BAM文件的文件结构与特性。
我们之前学习到了从SAM文件是用来存储序列mapping结果的标准格式,BAM文件是SAM文件的压缩格式,二者在信息层面是等价的。
SAM/BAM文件的前面5列,分别记录了,各位可以对照下图1中的内容对应一下。
1. 序列的名称;
2. FLAG值;
3. 比对到的染色体;
4. 比对到的染色体的具体位置;
5. 比对的质量值, 也叫MAPQ;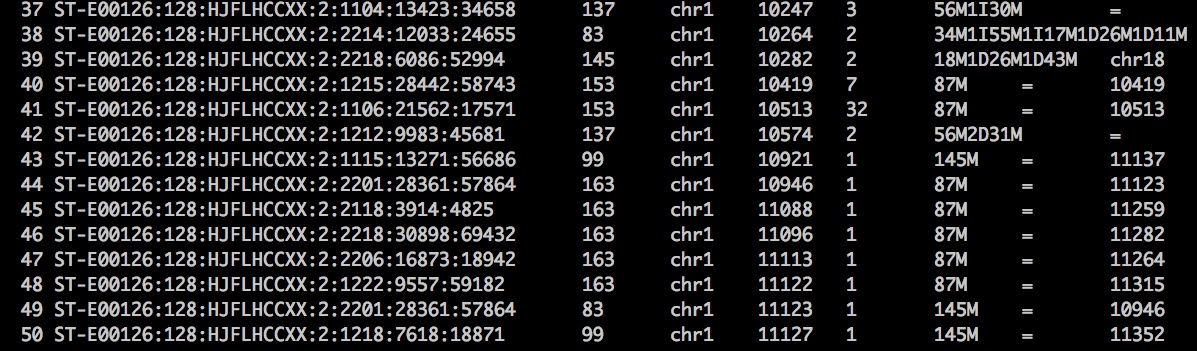
图1 全基因组测序的比对数据
那么第6列信息到底是什么呢?它其实是比对的一个简单描述,有一个很好听的名字叫CIGAR值(对滴,就是雪茄烟的那个单词)。
CIGAR = Concise Idiosyncratic Gapped Alignment Report
我们先来简单理解一下CIGAR值。
例子1:如图1第37行,CIGAR = 56M1I30M;
它的含义就是:这条序列与参考基因组相比;
前56bp能够match上;
中间有1bp的insertion(相比于参考基因组有1bp的插入);
最后是30bp的match

例子2:如图1第50行,CIGAR=145M,
含义就是:这条序列与参考基因组比对的结果是145bp完全match上。
那么常用的CIGAR标记符号都有哪些呢?根据SAM格式的官方文档如图2所示。
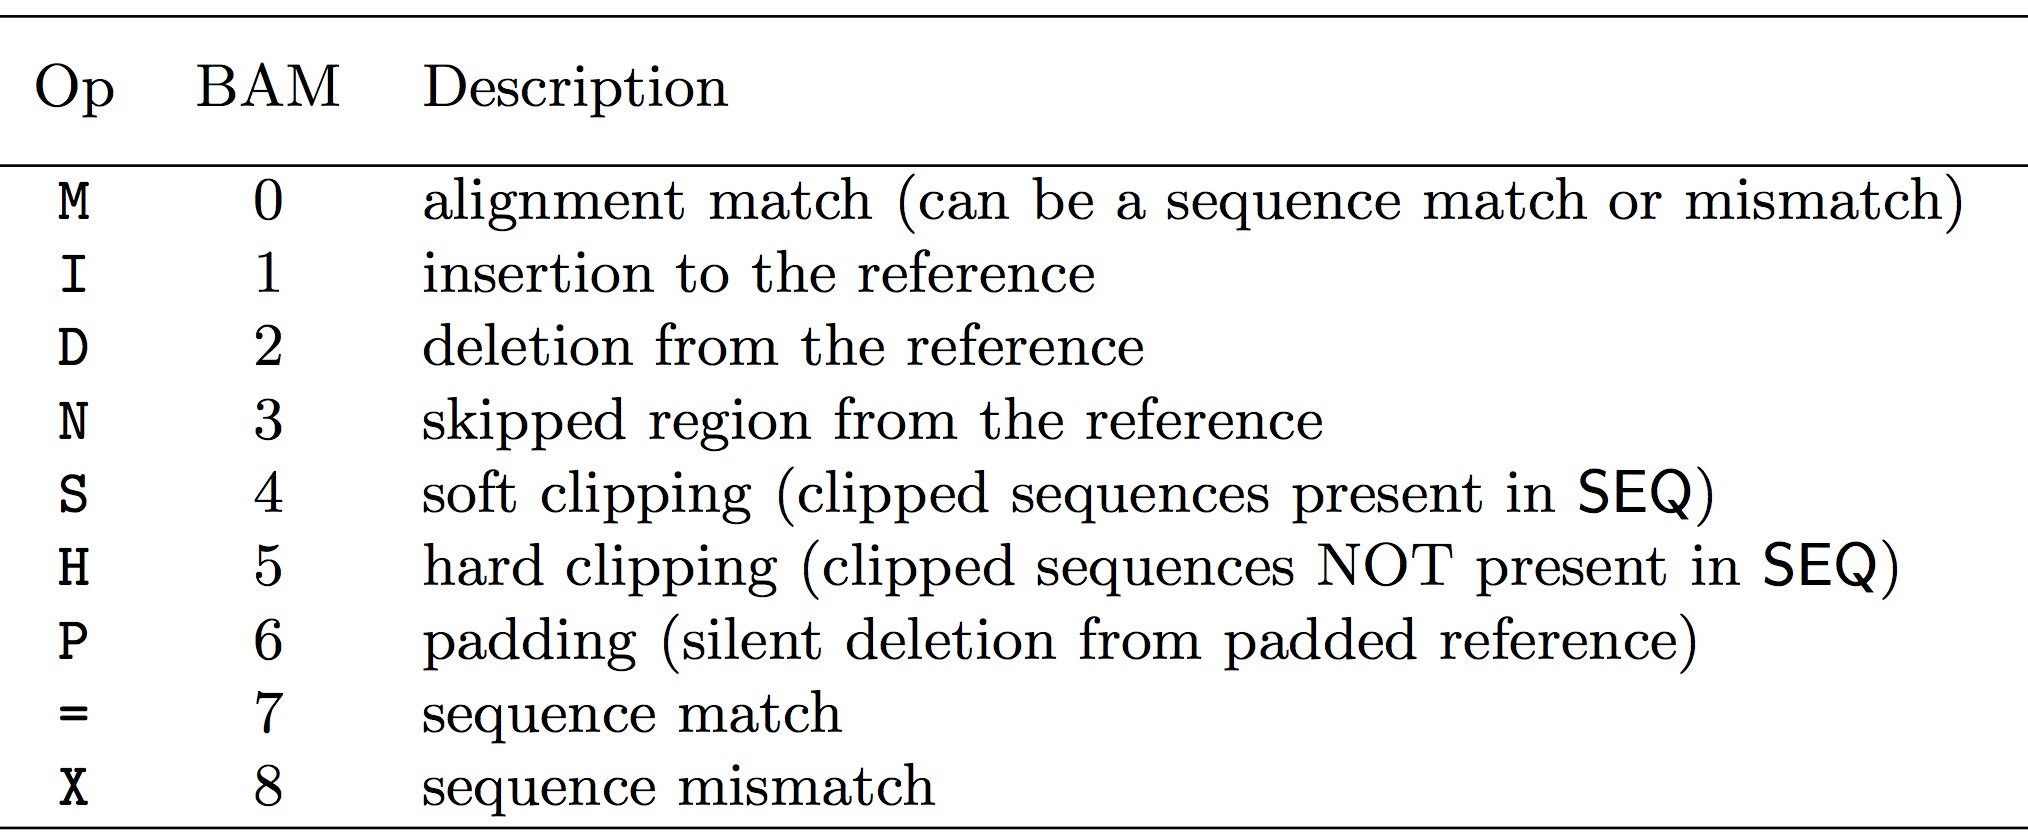
表1 常用的CIGAR符号
目前,我们只需要了解到前面7个,后面的=,X已经很不常用了,大家可以先忽略一下。
参考答案
我们今天就是让大家去理解CIGAR值到底是什么,因此我们今天的问题就是:
1. M,I,D,N分别是什么意思?如果1条序列的CIGAR=150M, 那么是不是可以说这150bp的区域中没有mismatch(错配)的现象?
M:序列匹配或错配
I:参考序列上的插入
D:参考序列上的缺失
N:参考序列上的跳跃区
150M不能说150bp区域区域中没有错配,因为M表示完全匹配;
但是无论reads与序列的正确匹配或是错误匹配该位置都显示为M 。
2. 如果1条序列来自于成熟的mRNA,在mapping到基因组的时候会有什么问题?如果这条序列中间正好跨过了200bp的intron,前后各有75bp mapping到了exon上,那么这条序列的CIGAR值应该怎么写?
- 错配,intron,跳跃区;
- CIGAR:75M200N75M
3. 根据下图提示,请理解clip的含义,无论是softclip还是hardclip。
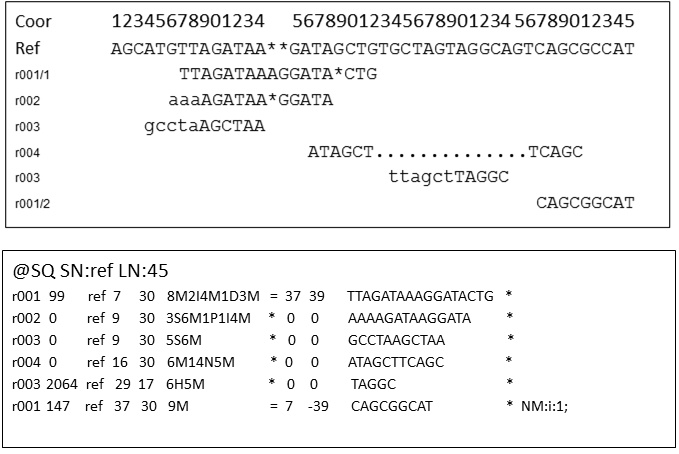
图2 引自 http://bioinformatics.cvr.ac.uk/blog/tag/cigar-string/
以r003序列为例,两个比对结果中序列剪切之后进行比对,那么所对应的CIGAR分别是5S6M和6H14N5M;
最终bam文件中序列分别是11bp和25bp,
这说明,在read进行softclip后,reads的原始信息在BAM文件中依然保留;
但是hardclip中,reads只在BAM文件中保留了切除以后的序列将直接被删除。
大家在看了我们的BBQ100活动以后,也不要忘了支持我们的知乎Live!
孟浩巍的知乎 Live - 生物信息学
购买任意一个上面链接内生物信息学的知乎Live都可以加入我们的生物信息学交流群。
目前群已经有1000多人了!
谢谢大家的支持!
D.5 BBQ100-20
问题描述
Hello大家好!今天我们又见面了!
今天我们来继续探索SAM/BAM文件的信息列。
我们之前已经说过,1个标准的SAM文件包含前面的11列标准信息列和若干标识符信息列(如表1所示),其中前面的6列我们已经为大家解释清楚。那么今天我们来继续探索剩下的7到11列。 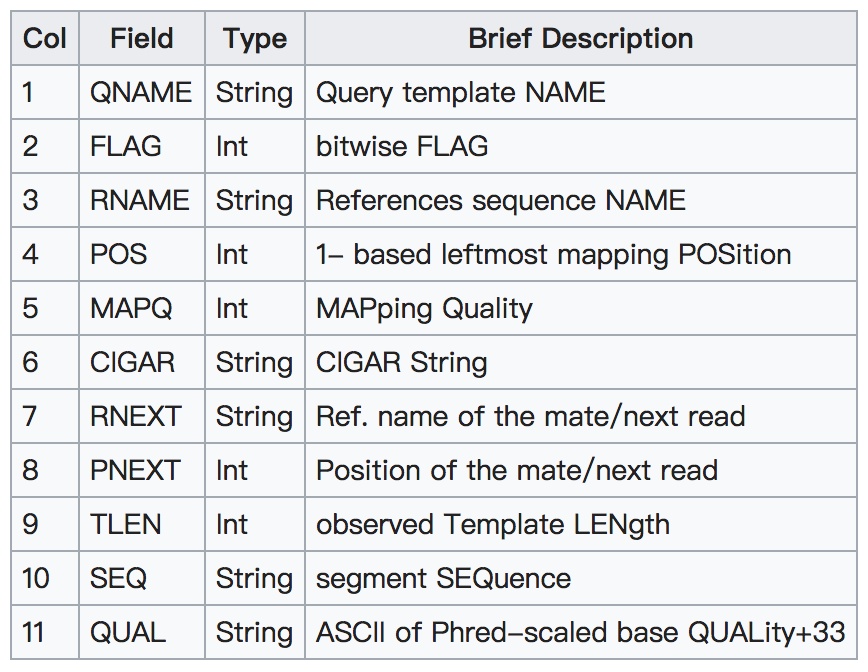
表1 SAM格式的标准11列信息介绍
第7列,一般情况下是指Pair read的另一半的比对的参考基因组;
第8列,一般情况下是指Pair read的另一半的比对的参考基因组的坐标;
第9列,可以简单理解为这1对read比对到基因组上以后,上游第1个碱基到下游最后1个碱基的距离。如果用负号表示是下游的序列;如果是正数表示为上游的序列;如果是0表示只是单端比对上;
第10列,进行比对read的序列信息;
第11列,进行比对read的质量信息;
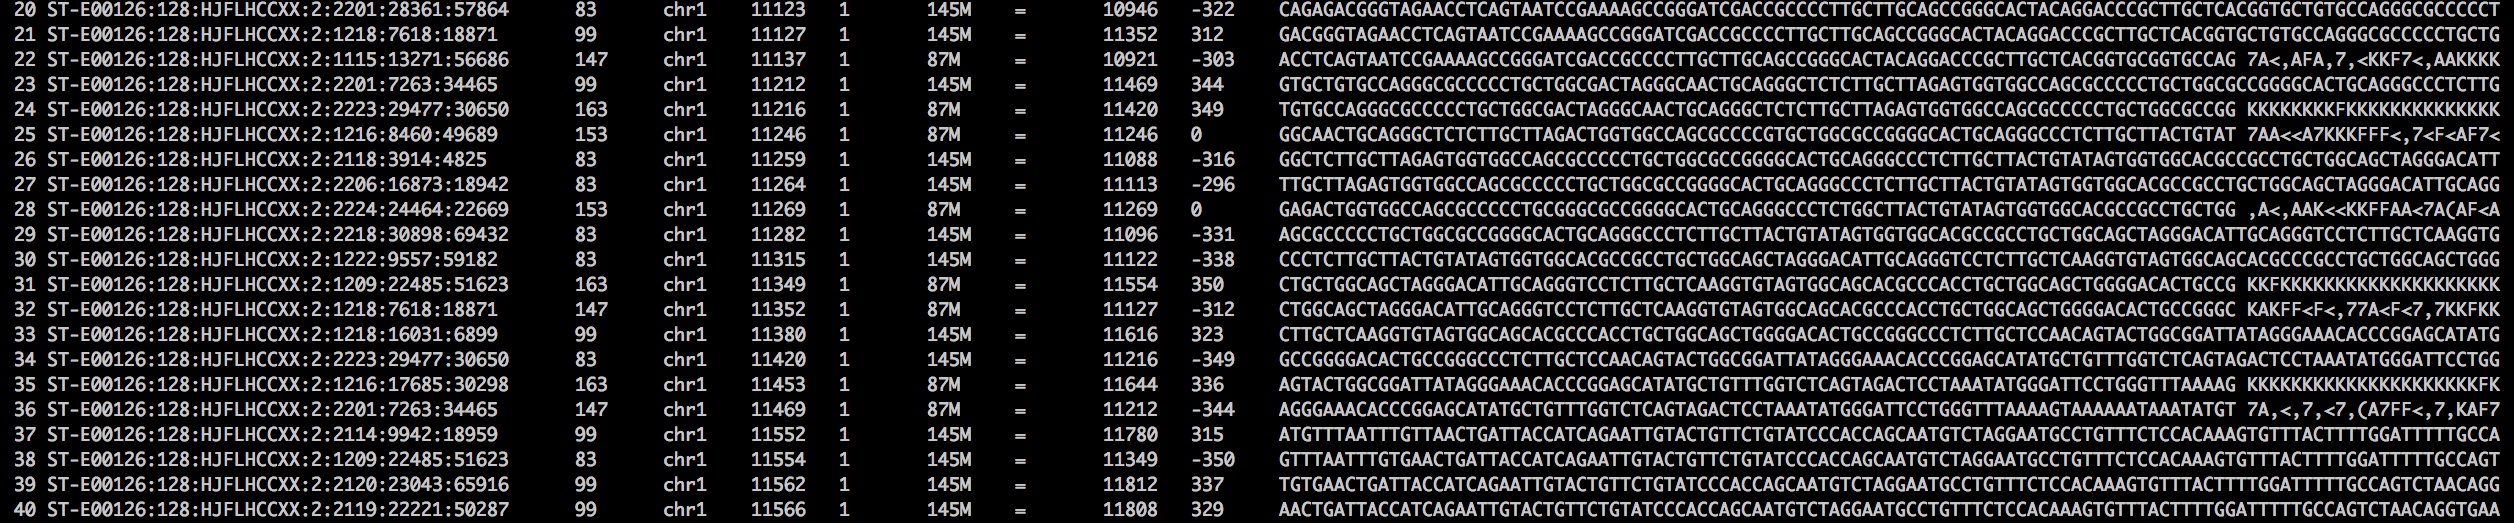
图1 SAM文件的截图,包含11列
对于我们今天的简单讲解,其实还涉及到很多概念,就比如在SAM官方文档中,对template,segment,read的各自定义就很让人挠头,我也是用了很长的时间才弄懂学会的。大家有兴趣的可以看一下图2我的截图,看看里面的定义
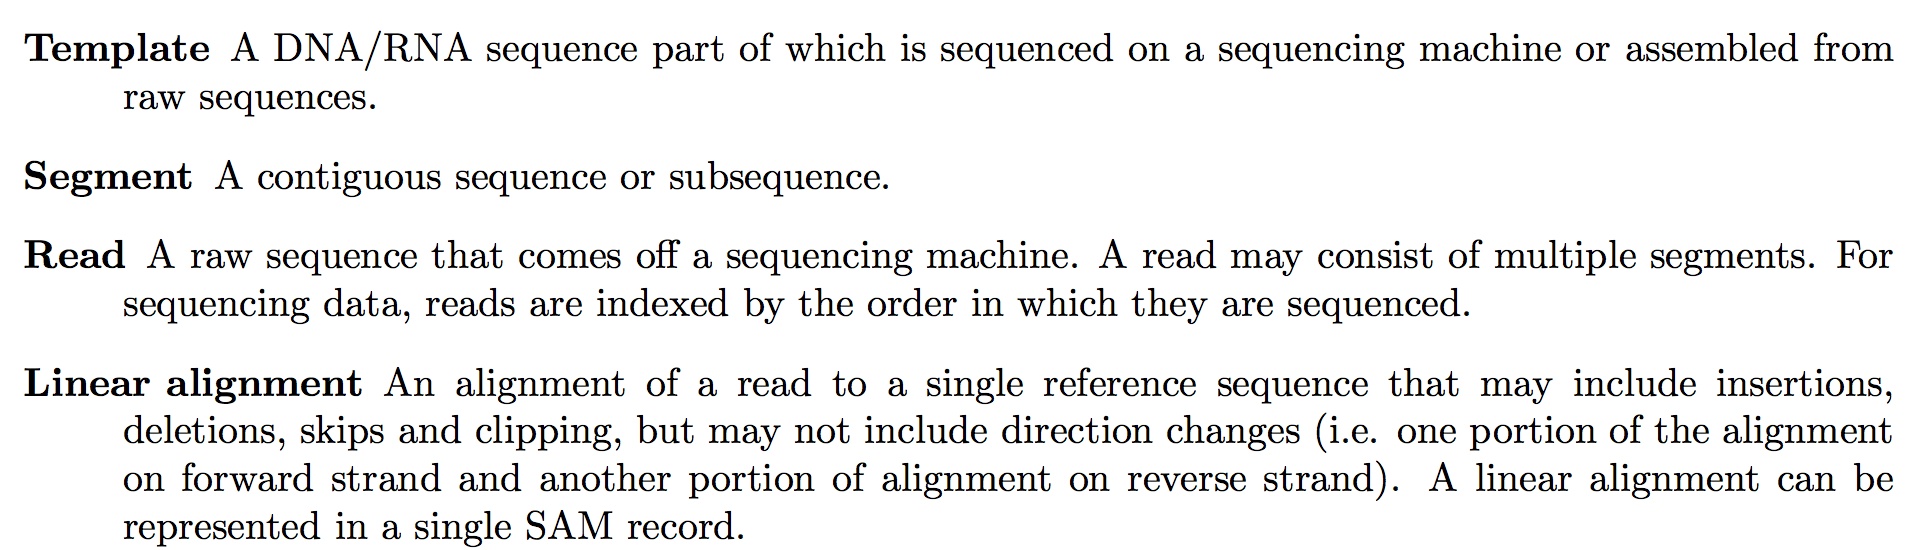
图2 SAM官方文档中对一些概念的解释(很让人难懂)
参考答案
那么我们今天的问题如下:
1. 图1中第20行,第9列记录了TLEN值,请你根据今天的文章与图1中的信息,列出算式计算TLEN值。
-(11123-10946+145) = -322 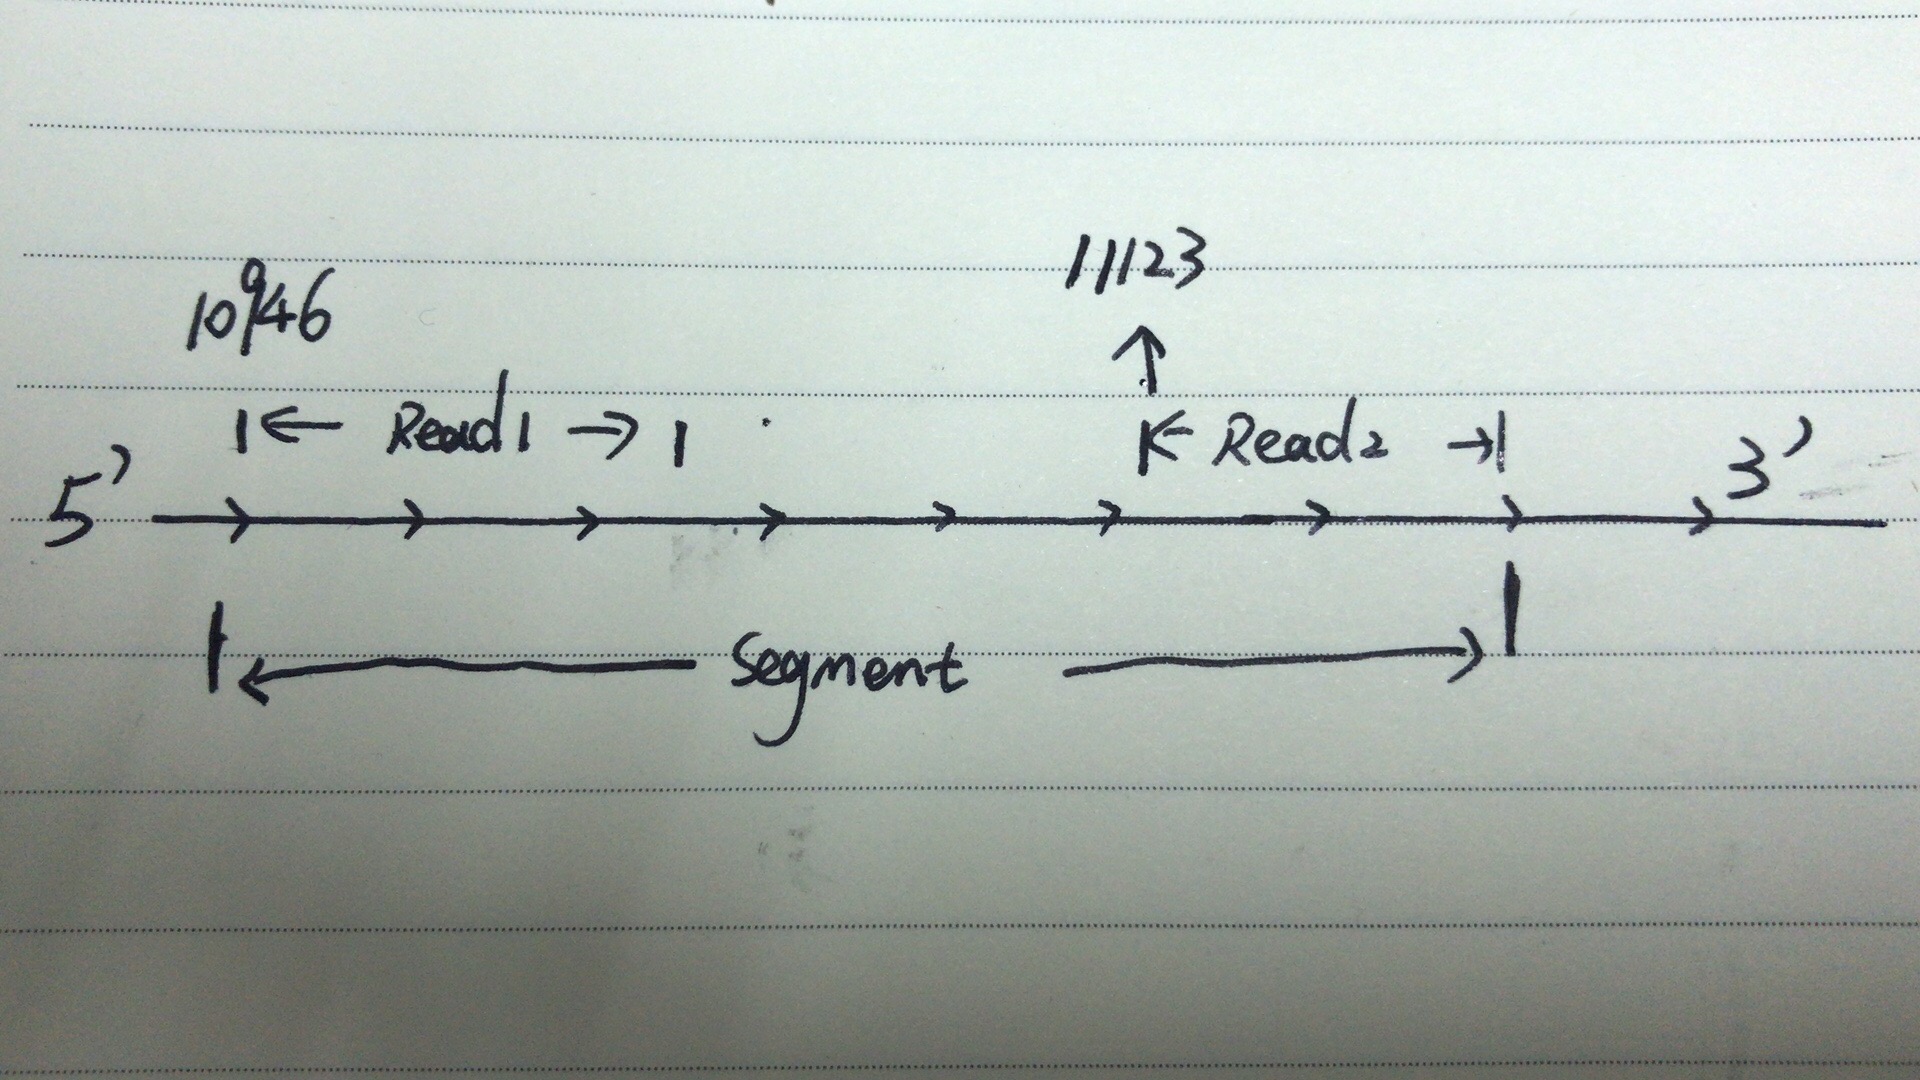
2. 如果使用FASTA文件作为input,第11列的质量值是否还有意义?为什么?
没有意义,因为fasta文件信息不包含read的质量值,11列的质量值本身是测序质量值,所以没有参考意义。3. 有没有可能通过SAM文件,提取里面的序列信息并转换成FASTQ格式的文件?如果可能,请你写出程序思路。
samtools view -b -h -S filter_MAPQ20.sam > filter_MAPQ20.bam
samtools bam2fq filter_MAPQ20.bam > filter_MAPQ20.fastq

# [M::bam2fq_mainloop] processed 629 reads