附录 C — 基础问题 11—15
本组保留原题和原稿参考答案。题库目前收录 1—25 题;历史仪器参数和软件用法仍需逐项更新。
对应 质控与比对。
C.1 BBQ100-11
问题描述
Hello大家好!我们又见面了!
通过前面的生物信息学10个基础问题,我相信大家对测序的基本原理,FASTA与FASTQ格式以及FastQC的质控报告都有了一个清楚的认识。那么接下来,我们就要进一步学习,学习如何把原始的FASTQ测序结果一步一步的准备成可以用来比对(mapping)的质控过后的FASTQ。
在生物信息学100个基础问题 —— 第10题 读懂FastQC报告之adapter与kmer中,我们知道,测序结果中可能会有若干条序列存在adapter的信息,而adapter的信息一般是不在基因组上存在的。所以,在比对之前如果不把adapter去干净,我相信你会得到1个非常非常低的mapping rate。 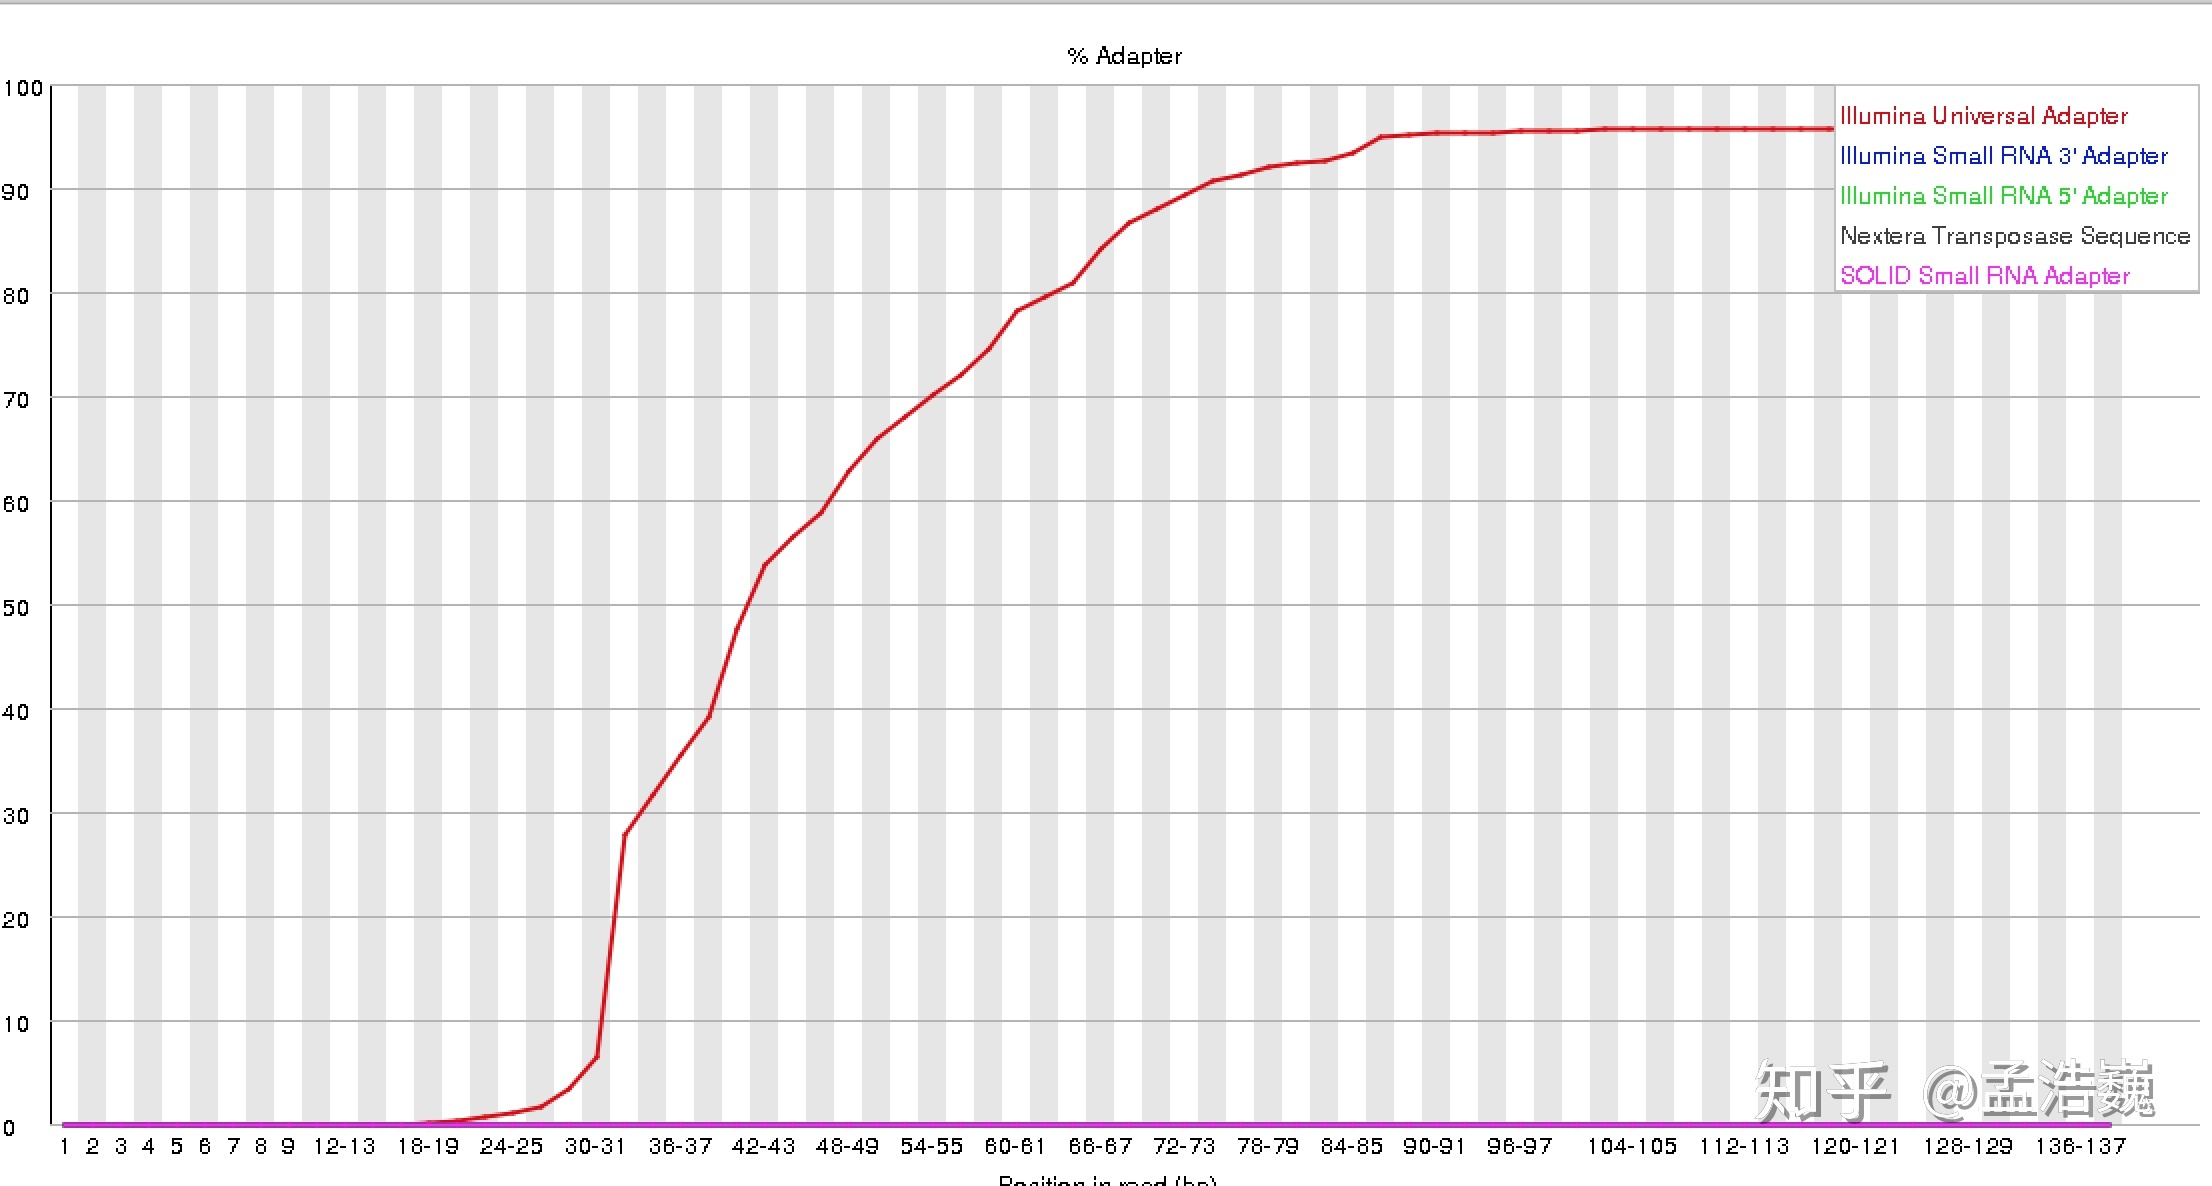 通常情况下,我们都是使用cutadapt这个软件进行adapter(接头)序列的去除。cutadapt这个软件不但支持单端序列,还支持双端序列的切除,同时还支持gz格式的自动压缩与解压缩。1个常用的切除命令类似: 在linux 命令行模式下
cutadapt -a ADAPTER_FWD -A ADAPTER_REV -o out.1.fastq -p out.2.fastq
reads.1.fastq reads.2.fastq- -a是第1个文件的adapter序列
- -A是第2个文件的adapter序列
- -o是第1个输出文件
- -p是第2个输出文件
- reads.1.fastq 是第1个输入文件,也就是双端测序中的read-1
- reads.2.fastq 是第2个输入文件,也就是双端测序中的read-2
那么我们今天需要思考的问题,与切除adapter的具体内容有关。
1. cutadapt中-a/-A 参数与-g/-G参数分别代表什么意思?Illumina测序过程中,一般不会用到哪个参数?
-a 后面跟一段核苷酸序列,代表单端测序中3'端需要去掉的adapter;
-A 代表双端测序中,read2的3'端需要去掉的adapter;
注意:如果是双端测序数据,-a针对read1起作用;

-g 后面也分别是一段核苷酸序列,代表单端测序中5'端adapter序列;
-G 的用法可以类比-a/-A,是针对reads2的5'端的adapter;

通常情况下,Illumina测序过程中5'端不会测出adapter序列,所以-G/-g一般不会被用到。
2. cutadapt可以过滤一些非常短的reads,请解释其中-m 参数是什么意思?为什么要过滤一些非常短的reads?
-m 后面跟着是一个数字;
意思是当每条read切完adapter后如果序列长度低于这个数字就会被舍弃,
因为如果序列长度过短,则这条read不宜被用于后续的mapping。
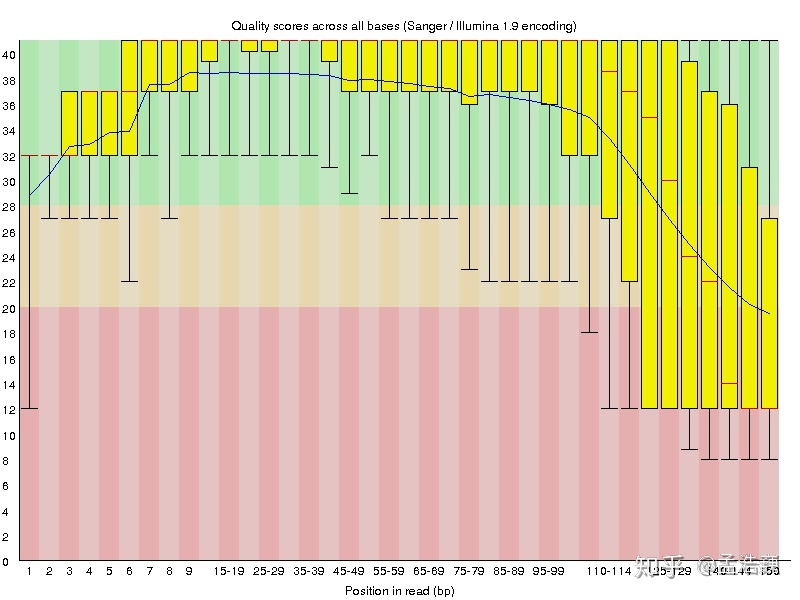
3. 在测序的过程中,我们经常发现一些序列的3’端的测序质量不太好(如图2所示),即使去掉adapter以后还是需要把低质量的序列再去除1次,从而保证后续的mapping质量。cutadapt可以使用一些办法来去除3’端质量不太好的序列。请说明用哪个参数来设置相关的cutoff,并简要说明cutadapt对read质量判断的策略与方法。
使用-q命令可以再在cut adapter时将测序质量值差的序列去掉,设定一个质量值,低于该分数的bp将被
切掉,具体命令是:
    > cutadapt -q 10 -o output.fastq input.fastq

需要注意的是,-q后面的数字表示质量值的低阈值,如果FASTQ文件质量值采用pherd33标准,则不用备注;
但如果FASTQ文件采用phred64标准,则需要在代码中添加 “--quality-base=64”。

- - - - - - - - - - - - - - - - - - - -
cutadapt 去除3'端低质量序列的核心算法
- - - - - - - - - - - - - - - - - - - -
phred = -10 × log10(Error Probability)

假设我们有13bp的序列,其序列和phred值分别为:
    A,T,G,C,C,G,T,A,C,C,G,G,T,T,A
    42, 42, 41, 41, 40, 26, 27, 8, 7, 11, 4, 2, 3

假设我们的-q参数选择10,首先先对所有序列的质量值减去这个-q后面的参数,结果:
    32, 32, 31, 31, 30, 16, 17, -2, -3, 1, -6, -8, -7

随后从3'方向向5'方向进行累加,结果如下:
    164, 132, 100, 69, 38, 8, -8, -25, -23, -20, -21, -15, -7

则从3'到5'遇到累加结果的第1位大于0的位置即为保留的第1位;
所以最终保留cut的结果为:
    A,T,G,C,C,G,T,A--cut here--C,C,G,G,T,T,A

这样做的好处是可以得到比较稳定的高测序质量值,防止因为3'端某个质量值突然提高而终止去除。
C.2 BBQ100-12
问题描述
Hello大家好!我们又见面了!
上一次我们说到了cutadapt软件的使用问题,其中我们着重强调了1个参数-m,不知道大家还有没有印象。今天我们问题就是要使用-m参数和另一个工具联合的一个妙用。不过在这之前,我们还得先介绍1个工具箱叫fastx_toolkit.
fastx_toolkit是一个系列内容的软件包,其中主要的内容是对比对前的fastq文件做质控。比如切掉一些不要的内容(fastx_trimmer),比如FASTQ与FASTA格式的转换(fastq_to_fasta),比如分单链测序的index(fastx_barcode_splitter)等等。我们今天主要是给大家说一下fastx_trimmer的用处。
fastx_trimmer主要是切掉一些fastq中你不想要的序列,比如有些序列5’端有若干bp的质量不好的或者碱基不稳定的部分;或者是5’端有一些用来去重复(duplicate)的random barcode(如图1所示);还可能是3’端一些质量不好的碱基。 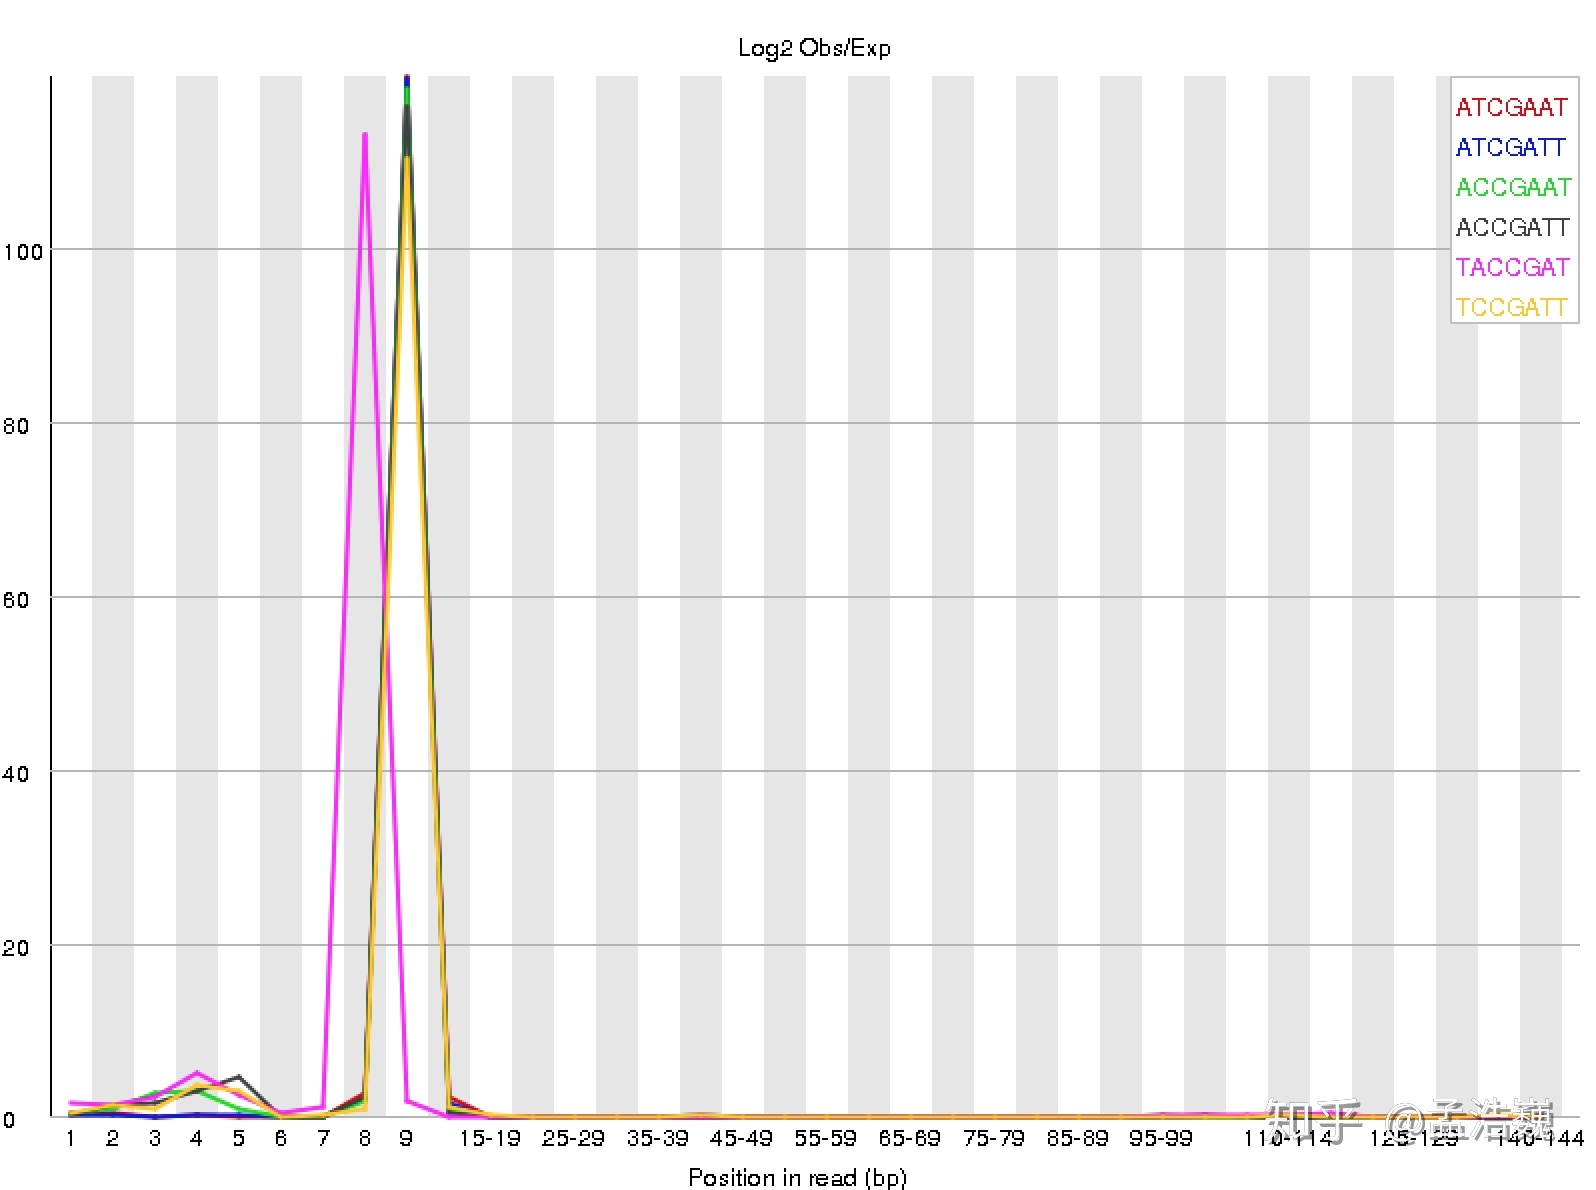 这里我再给大家1张图,就是之前我们展示过的Human普通的RNA-Seq测序的adapter分布图(图2)。
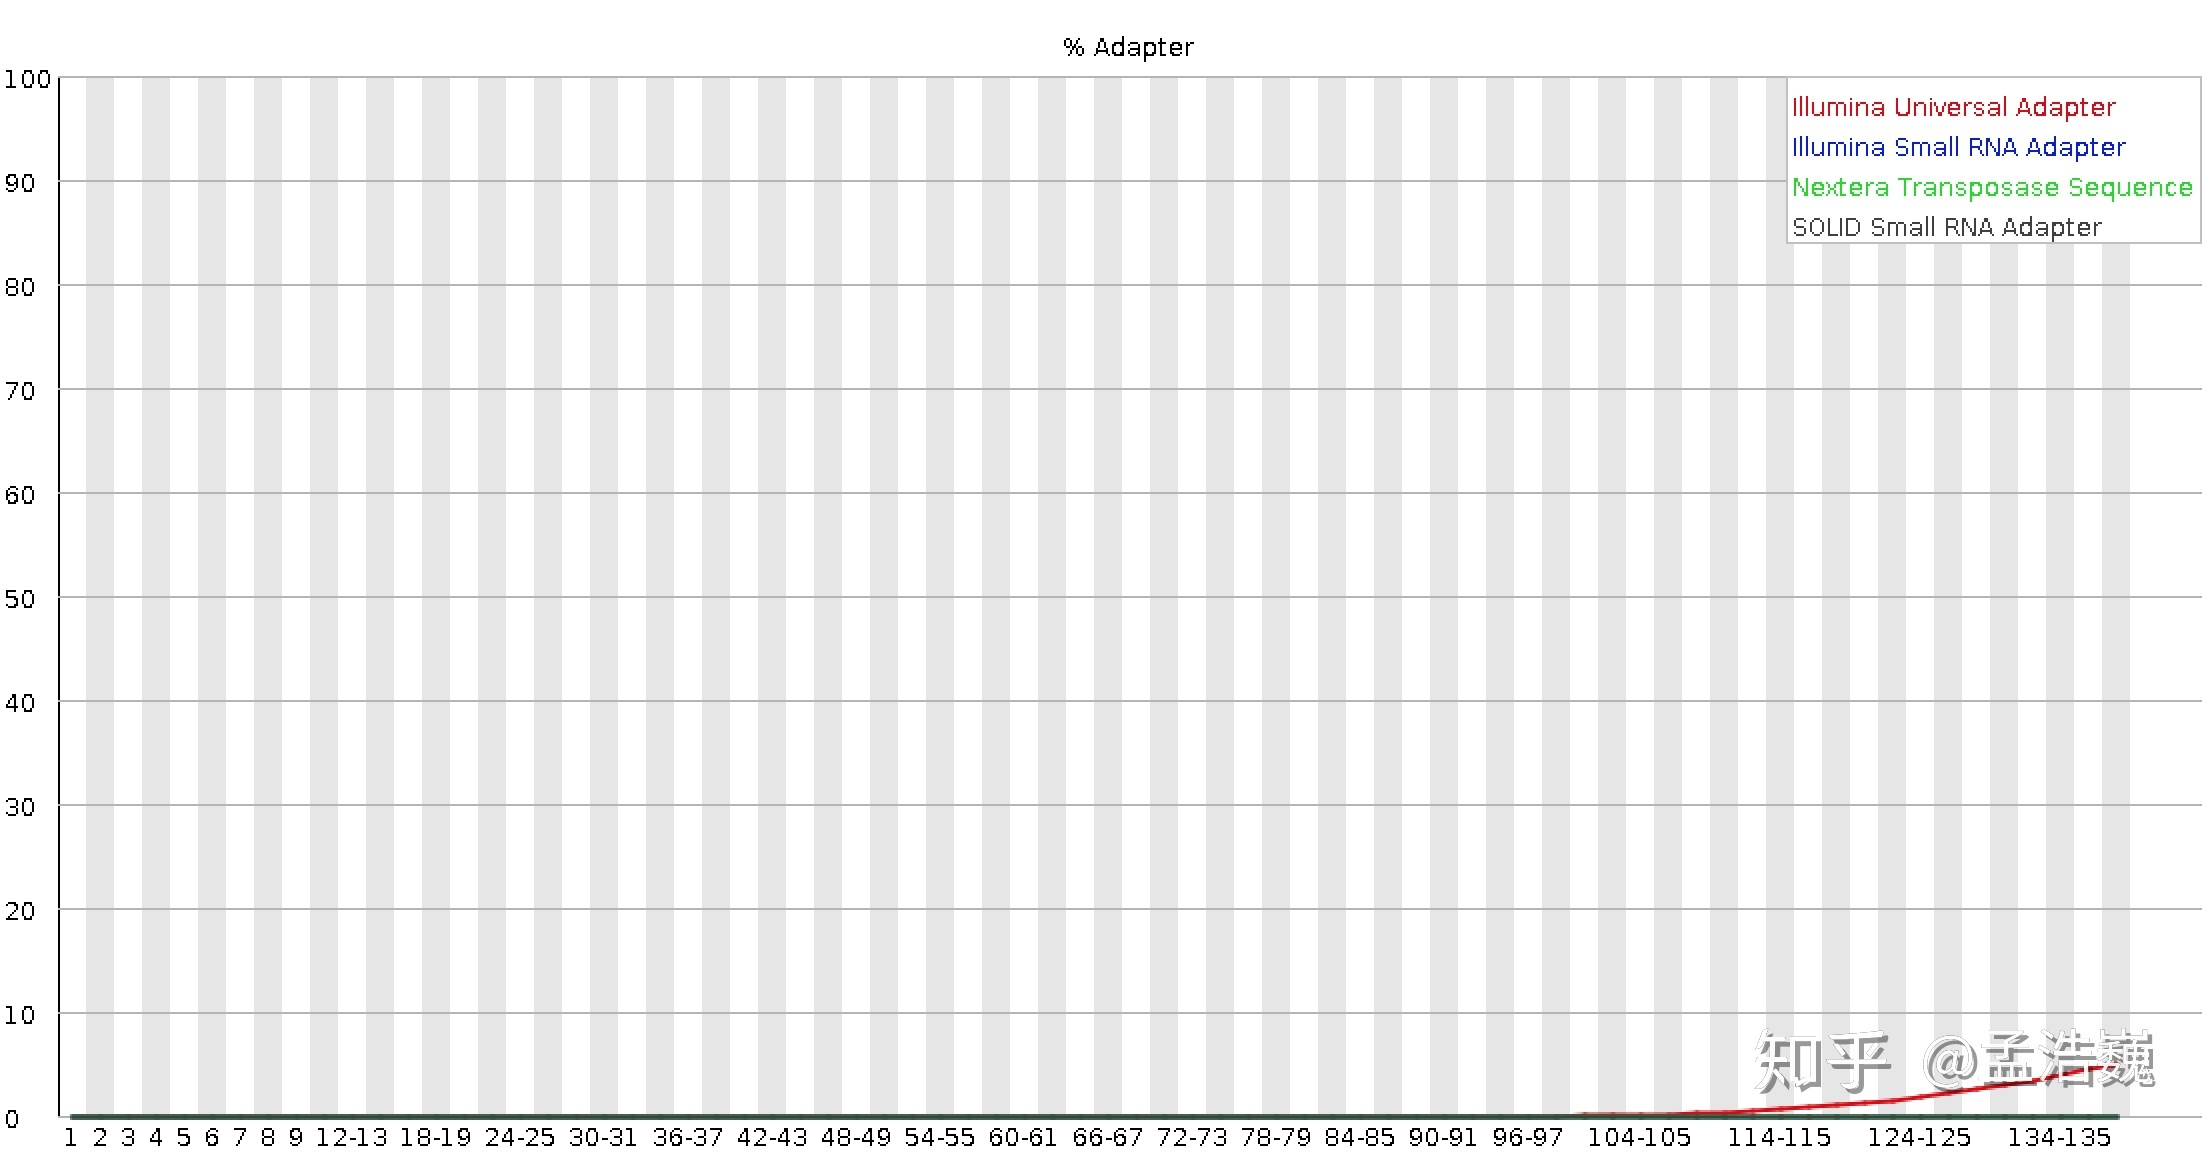
在实际数据分析与处理的过程中,会有下面几个要求:
1. fastq文件中的adapter肯定是需要去掉的;
2. 一些头部的random barcode也是需要去掉的;
3. 在进行一些特殊的分析的时候,还需要保证所有的输入序列长度完全一致,不能长不能短,必须整整齐齐在一起(比如RNA-Seq的可变剪切分析经常有这个要求)。
那么我们今天的问题就是——
假设你有一个RNA-Seq测序文件需要进行可变剪切分析,你需要达到的要求是:
1. 处理过后的fastq文件中不包含adapter序列;
2. 处理过后的fastq文件中的开头10bp是random barcode也需要去;
3. 最后得到的序列长度完全一致(不满足上述要求的扔掉);
假设我们的输入文件是:input.fastq 假设我们的操作系统是:Linux Ubuntu 其中的adapter序列是:AGATCGGAAGAGCGTCGTGTAGGGAAAGAGTGTAGATCTCGGTGGTCGCCGTATCATT 请参考cutadapt与fastx_trimmer这两个软件的使用说明,设计处理路线图。如果有可能,请给出相应的参数。
为了达到最终目的,处理过程主要分为3步:
第1步:
    使用fastqc获得序列3'端adapter以及5'端random barcode的信息;

第2步:
    使用cutadapt去掉3'端的adapter,务必注意需要使用-m参数,只保留一定长度以上的序列;

第3步:
    使用fastx_trimmer去除5'端不想要random barcode,同时截取相同长度的序列,
保证最后得到的序列长度完全一致。

参考代码及参数如下:
# step 1, FastQC
fastqc -q -t 3 -o ./FastQC_result ./input.fastq

# step 2, cut adapter
cutadapt -25 -m 125 \
-a AGATCGGAAGAGCGTCGTGTAGGGAAAGAGTGTAGATCTCGGTGGTCGCCGTATCATT \
-o input_cutadapt.fq.gz input.fastq &

# step 3, trim
zcat input_cutadapt.fq.gz | fastx_trimmer \
-f 11 -l 125 -z -o ./input_cutadapt_trim11_125.fq.gz

# 经过上述3个步骤,可以获得长度统一为115bp的序列!
C.3 BBQ100-13
问题描述
Hello 大家好!
经过我们之前的12个问题,我们对Illumina 测序的原理,测序的储存模式,测序数据的质控已经有了一个比较清楚的认识。那么我们今天就开始用接下来的若干次提问来学习与比对有关的知识。
比对其实应该对应的单词是alignment,但往往特指低通量的序列之间的比较。比如10条序列,进行多序列比对就是我们常说的 multiple alignment问题;如果是2条序列的比对,我们经常称其为pairwise alignment.
回贴通常对应的单词应该是mapping,一般指高通量的数据去寻找基因组的位置。比如我们进行测序以后,有10M对read pair,要去寻找他们在基因组上的位置,这个时候就是一个典型的mapping问题。
alignment与mapping其实是密切相关的概念,所有的mapping软件其实都是从低通量的办法逐步改进而得到的。
今天我们的问题是,请各位学习一下北京大学高歌老师的《生物信息学:导论与方法》中的双序列比对(pairwise alignment)的相关算法。主要是Needleman-Wunsch算法(全局比对)和Smith-Waterman算法(局部比对)相关的内容,然后回答下面的问题。
每个视频长度都不长,希望大家认真看完!今天的内容是以后的基础,如果学不好,以后的高楼盖得再高,也有轰然倒塌的那一天!
课程视频的链接如下:
生物信息学:导论与方法(北京大学)-序列比对中的基本概念
https://link.zhihu.com/?target=https%3A//www.bilibili.com/video/av10042290/%3Fp%3D5生物信息学:导论与方法(北京大学)-利用动态规划进行全局序列比对
https://link.zhihu.com/?target=https%3A//www.bilibili.com/video/av10042290/%3Fp%3D6生物信息学:导论与方法(北京大学)-从全局比对到局部比对
https://link.zhihu.com/?target=https%3A//www.bilibili.com/video/av10042290/%3Fp%3D7
今天的问题:
如果我们假设比对的 scoring matrix 如下图1所示,同时gap的罚分d = -5
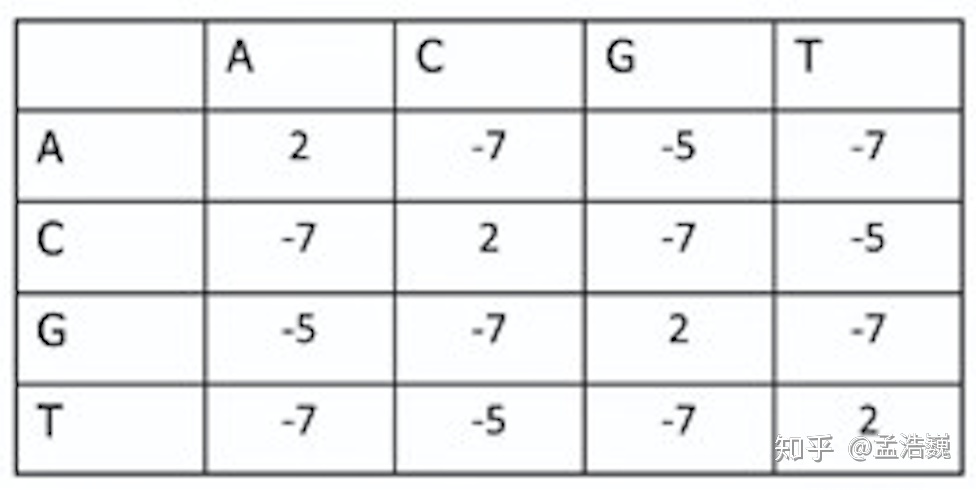
假设我们的 seq1 = AAGT,seq2=AGCT;那么我们进行双序列比对,需要填写下面的表格。 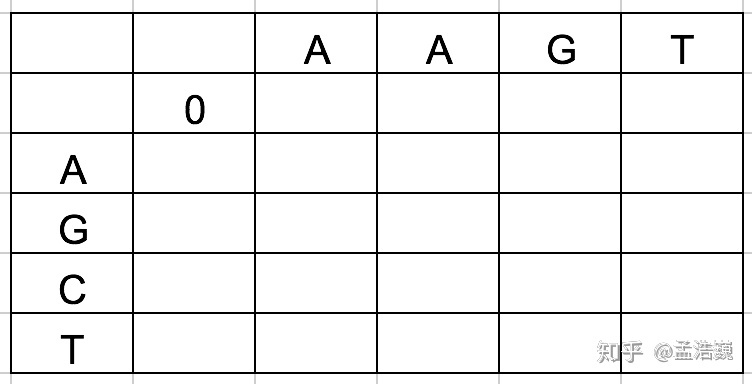
1. 使用Needleman-Wunsch算法(全局比对),那么表1应该怎么填写?最终的比对结果是什么?
计算过程如下: 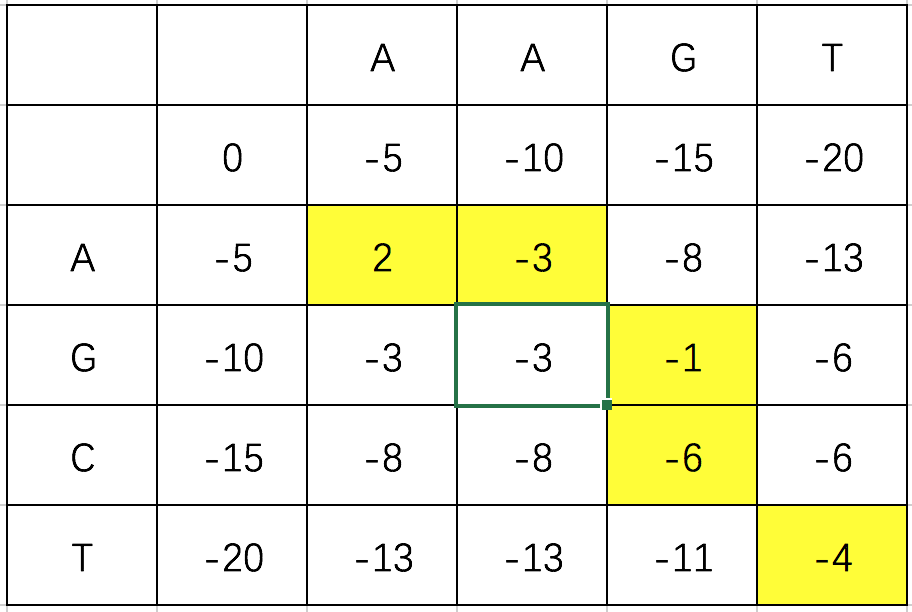 最终的比对结果为
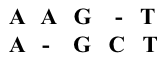
2. 使用Smith-Waterman算法(局部比对),那么表1应该怎么填写?最终的比对结果是什么?
计算过程如下: 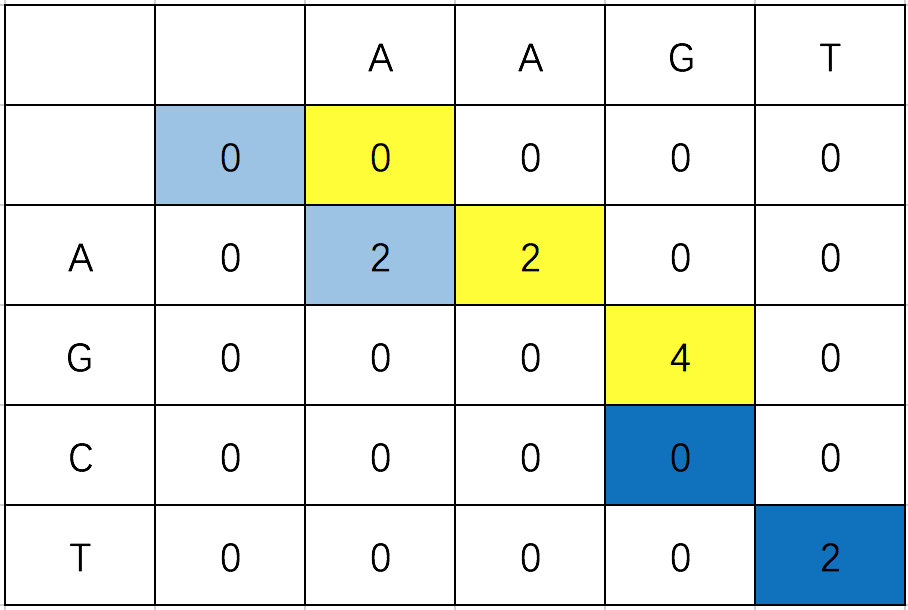
注意:在进行局部比对回溯的时候,需要从第1个非零的碱基开始,沿对角线方向到第1个遇到0的结果为止。因此本题中,局部比对的结果有3个:

第1个结果是(浅蓝色):
A
A

第2个结果是(黄色):
A   A   G
A   -   G

第3个结果是(深蓝色):
T
T
3. 请思考,为什么有的时候需要全局比对,有的时候需要局部比对?
全局比对,是从头到尾对序列的每一个碱基都进行比对,找到最优解;
局部比对,是为了找到两条序列中最相似的部分,可以有多个结果;

全局比对能找到2条序列比对的最优解,用处很大自不必说,单独说说局部比对的相关意义与必要性。

随着越来越多的序列信息的产生,人们发现对于:
1.某些蛋白序列虽然整体相差很大,但是对于某些特殊的功能域却有着极高的相似性;
2.而且在不同物种中序列和功能都相当保守,这在全局比对中是很难发现的;
3.另一方面随着70年代内含子的发现比对算法必须要能够处理由于内含子导致的大片段的差异。
C.4 BBQ100-14
问题描述
Hello,大家好!
从第13问开始,我们开启了序列比对之旅。
之前的第13题本质上是为了让大家学习双序列比对(pairwise alignment),接下来,我们不会去讲多序列比对(multiple alignment)的算法问题,因为多序列比对的不同算法各种各样,但很多时候的思路都是把多序列比对,分解成若干个双序列比对的问题,然后再进行最后的结果整合。所以,我们把pairwise alignment的原理与算法搞定了,就已经很OK了~
今天我们带大家思考1个问题,就是为什么要开发BLAST算法?
我们在第13问中学习到的是pairwise alignment的两种算法,全局比对算法与局部比对算法,无论哪种算法,得到的都是2条序列比对的最优解,当然某些时候最优解有可能有多个。那所有的序列比对问题是不是都可以用这种算法来解决了呢? 我们来算这么1笔账。
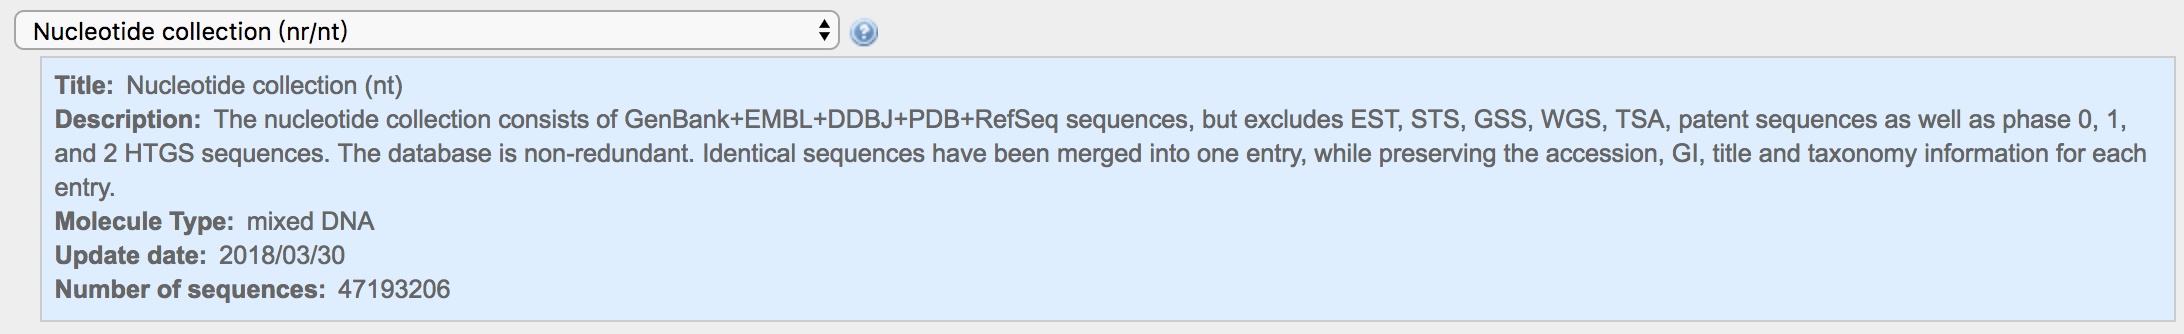 假设我有1条序列 SeqA = 100bp(这个不是很长哟~),我想找到这条序列的相似序列。目前已知的非冗余核酸序列库,序列有47193206条,按平均长度在0.1Mbp左右。如果我们想要找到SeqA的相似序列,使用局部比对算法,那么至少就需要100bp × 0.1Mbp × 47193206条 次比较运算等于471930 × 109,现在服务器最快的CPU,单核心1秒可以大约运行3×10⁹次,假设我们的服务器有20个核心,那么 ——
完成任务大约需要的时间 = 471930 × 10^9 ÷ 3 × 10^9 ÷ 20 = 7860秒 大约是130分钟;
如果我们的SeqA = 1000bp(这个也不是很长哟~ )那么时间就变成了1300分钟;
我们就为了找个相似性,就要花2个小时?这个肯定不划算吧? 所以,有了这个需求以后,一帮大佬就搞出个优化算法叫BLAST(Basic Local Alignment Search Tool)把上面这个任务的运行时间缩短到了1分钟以内。
我们今天的问题,也是请大家去观看北京大学-生物信息学导论里面的视频:
生物信息学:导论与方法(北京大学) - BLAST
在看完视频以后,请大家回答问题:
1. BLAST提高搜索速度的核心算法的名称是什么?
启发式算法!2. BLAST结果中E-value是什么意思?
在BLAST结果中每一条匹配序列都会有匹配的score值和E值;
S值表示两序列的相似度,分值越高表明它们之间相似的程度越大;
E值是可靠性的评价,它表明在随机的情况下出现这种相似度的序列的条数。
- - - - - - - - - - - - - - - - - - - -
S值越大越好,最大是100%;E值越小越好,注意E值有可能大于1!
3. 如果想要降低BLAST的假阳性,你通常需要做什么?
- Word size的选择,BLAST算法将目标序列分割成一系列具有字段长度的小的序列进行数据库搜索,因此当此值越小得到的搜索结果越多,假阳性也就越多。
- 根据序列长度调整E值,如果检索序列较短可适当提高E值,反之可降低E值。
- 空位罚分的选择,严谨的罚分会让相似度高的序列错过,而松弛的罚分会使检索结果过多。
- 序列检索前将低复杂度的序列先去除,尤其是DNA序列中的重复片段。
4. 假设给你一条序列,运行结果中序列相似度最高的来自于哪个物种?
>Protein Sequence
MVRAPCCEKMGLKKGPWTPEEDQILISYIQSNGHG
NWRALPKLAGLLRCGKSCRLRWTNYLRPDIKRGNF
TREEEDSIIQLHEMLGNRWSAIAARLPGRTDNEIK
NVWHTHLKKRLKNYQPPQSSKRHSKNKDSKAPCTS
QIALKSSNNFSNIKEDGPGLGSGPNSPQLSSSEMS
TVTADSLAVTMDISNSNDQIDSSENFIPEIDESFW
TDGLSTSGGGEELQVQFPFHDMKQENVEKDVGAKL
EDDMDFWYSVFIKSGDLLELPEF

**使用网站**

BLAST:http://blast.ncbi.nlm.nih.gov

**参数设置**

Database: Non-redundant protein sequences (nr)
Algorithm: blastp
Word size: 3
Matrix: BLOSUM62
Gap Costs: Existence: 11 Extension: 1
其他参数默认
运行结果: 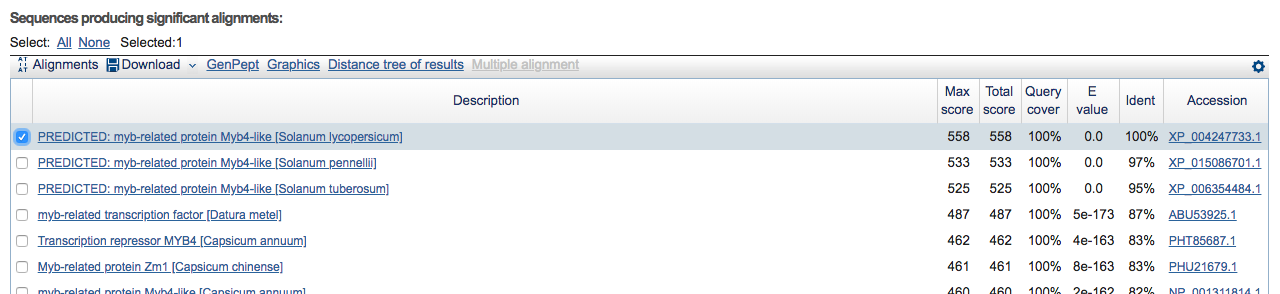 由图中结果可知,序列相似度最高的的物种是Solanum lycopersicum,番茄。
C.5 BBQ100-15
问题描述
Hello大家好! 我们又见面了!又是新的一周,又是元气满满的一天!
今天我们讨论讨论低通量比对的最后一次问题,来为大家介绍一下BLAT。
可能看到BLAT这个名字,你可能会懵逼,不是BLAST吗?怎么少了个S???我们来为大家解释一下这个问题。
BLAST = Basic Local Alignment Search Tool;
BLAT = BLAST-like alignment tool;
从名字上,我们可以知道结论,BLAST是为了寻找1条SeqA的相似序列。一般输入的是1条FASTA序列,使用的参考序列是所有常见生物,包括微生物在内的非冗余数据库。特点是可以找到所有已知序列生物的相似序列。
优点是全,缺点是有的时候输出冗余。
比如,有时我只需要在某一种我想要的物种的基因组上进行快速的序列定位,结果BLAST却把所有的相似序列都找出来了。从时间上,还有从输出的冗余程度来说,这都不是最优解。所以BLAT工具应运而生!
BLAT的功能,简单来说就是我有1条序列SeqA,我想知道SeqA在某一种基因组中的定位(比如human genome)的工具。
在线的BLAT工具地址是Human BLAT Search;
或者可以通过打开UCSC genome browser –> tools –> BLAT的方式打开;
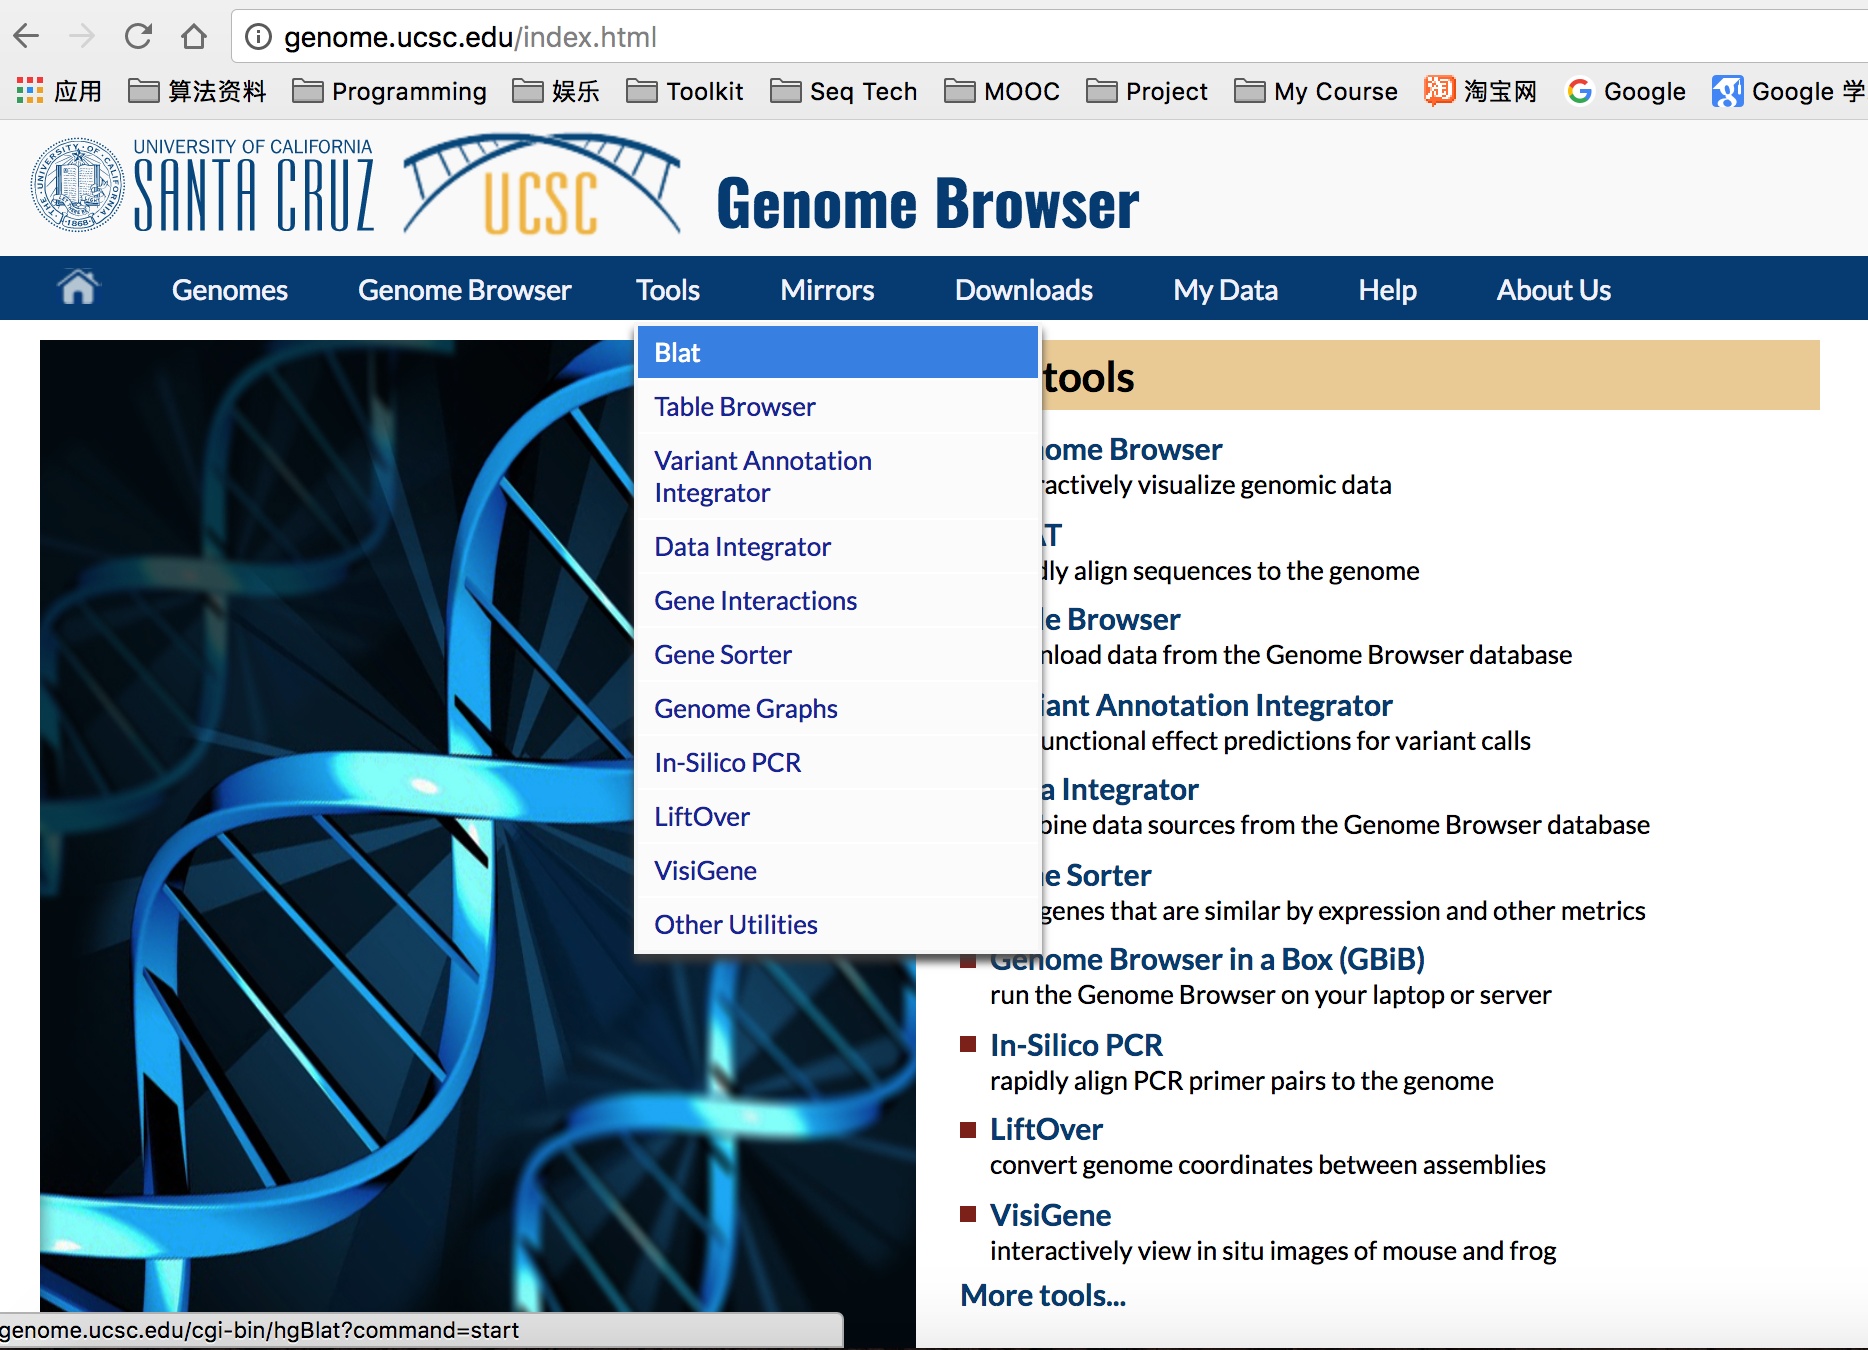 点开BLAT以后的页面如下:
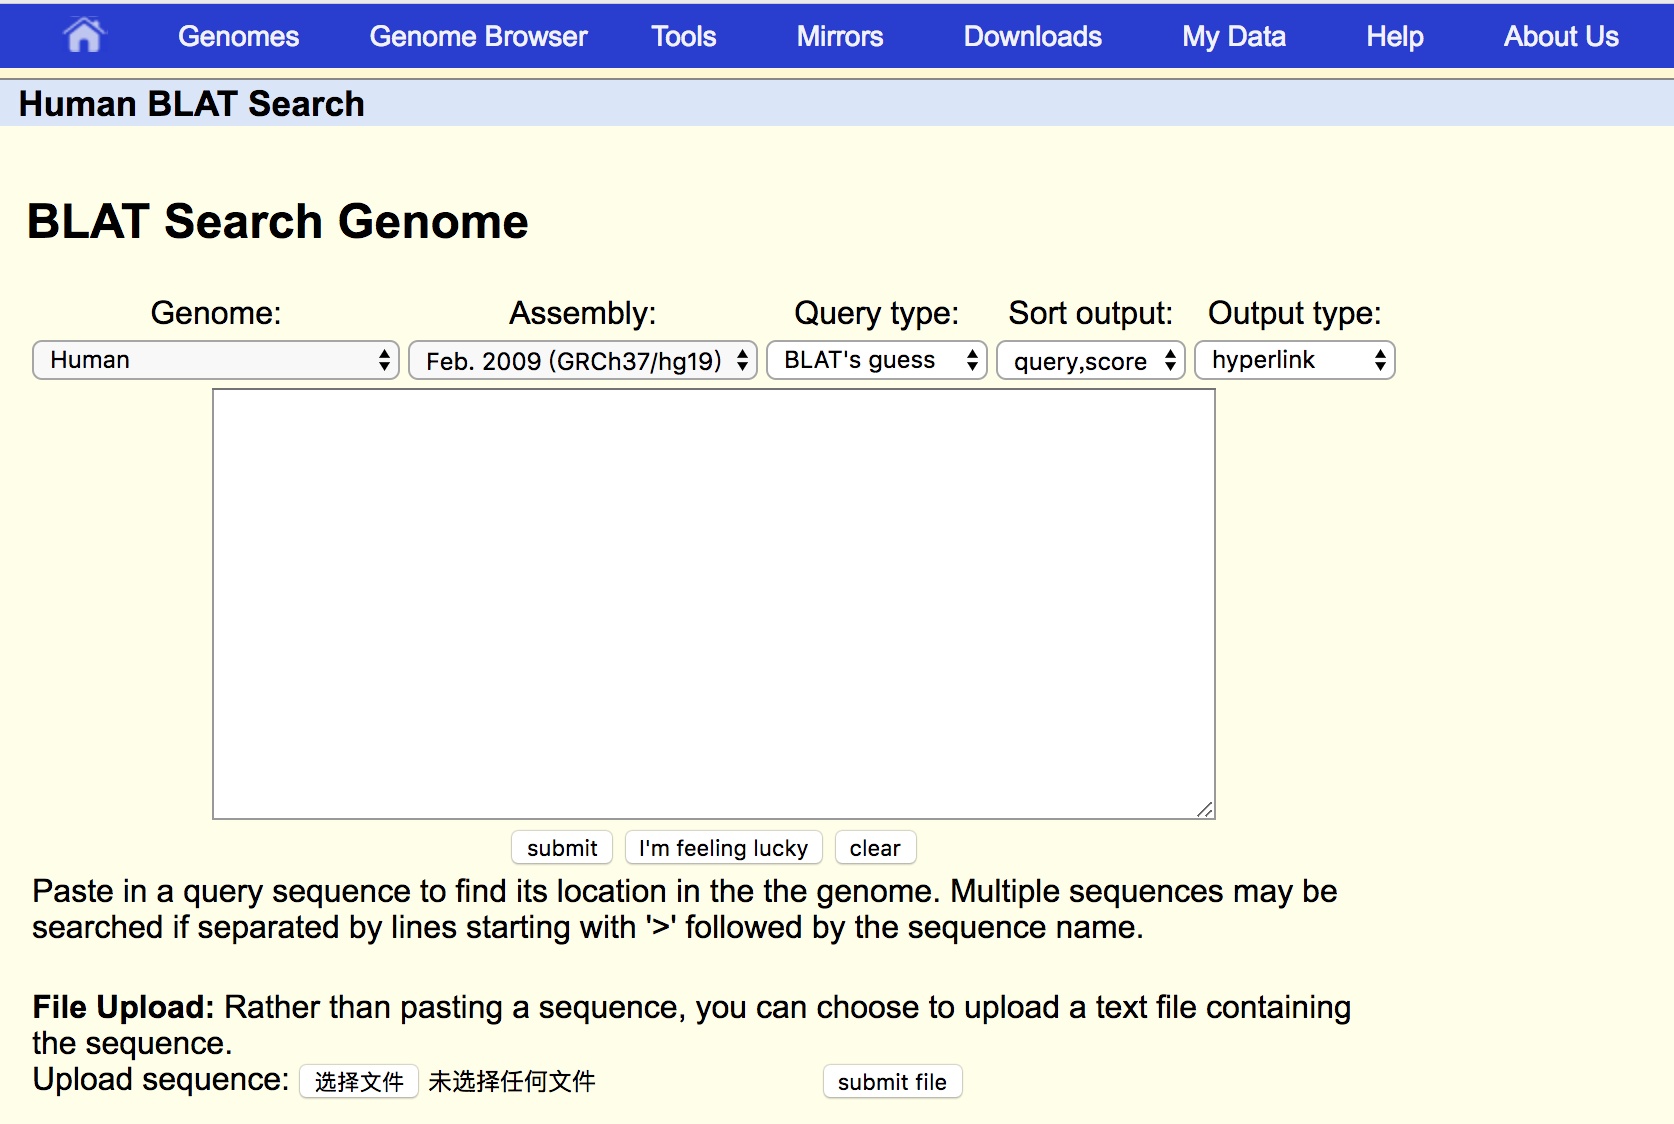 第1行是你要选择的基因组的参数,比如我们这里常用的就是人的参考基因组hg19版本。
下面的白框可以用来输入序列,用标准的FASTA格式就行。之后点submit就大功告成!
我们今天的问题比较具体,也是我实际分析数据的时候遇到的1个问题。
假设,我们有1个小RNA的测序结果,这些RNA的平均长度小于200bp;我们在比对到小RNA的序列库的候,发现有一个非常奇怪的现象。有2条miRNA的序列mapping到了非常多的reads数目,但是剩下的1800种miRNA总共才mapping到了10000条reads.
具体数目如下:
hsa-mir-7641-2 2000000
hsa-mir-7641-1 50000
通过miRBase检索,我们得到序列如下:
hsa-mir-7641-2 GUUUGAUCUCGGAAGCUAAGCAGGGUCGGGCCUGGUUAGUACUUGGAUGGGAG
hsa-mir-7641-1 UCUCGUUUGAUCUCGGAAGCUAAGCAGGGUUGGGCCUGGUUAGUACUUGGAUGGGAAACUU 请尝试使用BLAT,Pairwise alignment等工具探索并解释原因。
双序列比对(Pairwise alignment)请使用下面的工具:
EMBOSS Water < Pairwise Sequence Alignment < EMBL-EBI
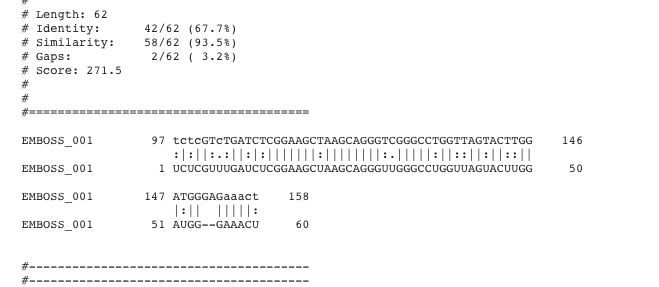
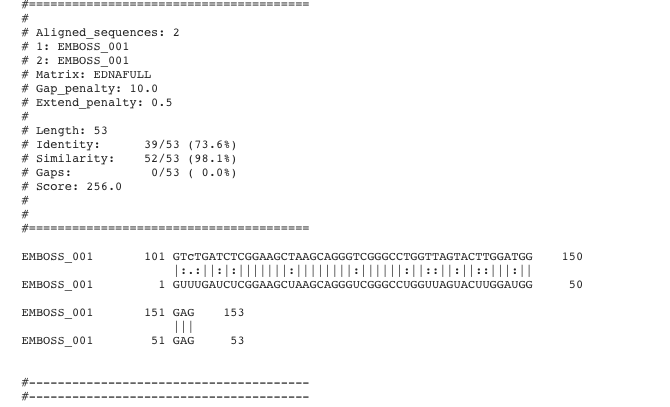
首先我们通过blat检索来看一下这两条序列分别定位于染色体上的什么位置,通过blat可得: hsa-mir-7641-2和 hsa-mir-7641-1比对到了5SRNA中间的一段序列上:


对5SRNA序列与两条目的序列分别做局部双序列比对:
hsa-mir-7641-1与5SRNA比对结果:
hsa-mir-7641-2与5SRNA比对结果:
两条目标序列局部双序列比对结果:
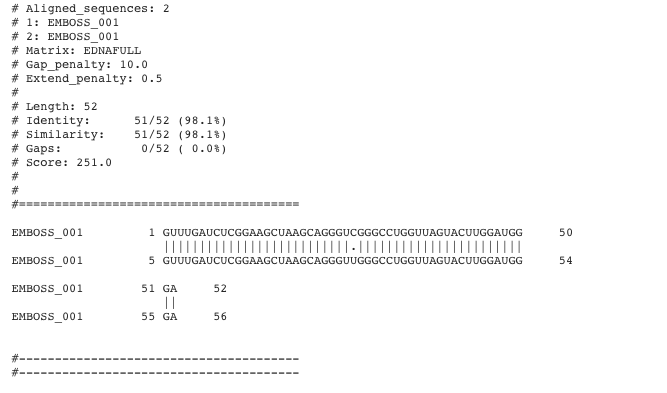
``` 从上述比对结果可以看出: 1.这2条目标序列与5SRNA中的一段序列高度重合; 2.这2条目标序列重合的区域高度相似; 结合前面的问题中提到本次实验属于小RNA的测序, 那么建库过程中核糖体RNA不可能完全去除,最终导致了之前的比对结果。